Die besten AI-SRE-Tools 2026


AI-SRE-Tools übernehmen den langsamsten Teil der Incident Response: herauszufinden, warum etwas ausgefallen ist. Was SREs früher Stunden gekostet hat, mit unzähligen offenen Tabs und einer Flut von Slack-Nachrichten, ist heute in wenigen Minuten erledigt.
Die Kategorie ist 2026 schnell gewachsen, und die Tools unterscheiden sich inzwischen deutlich: wie tief sie untersuchen, was sie ändern dürfen und was dabei mit Ihren Daten passiert. Wir haben uns 10 AI-SRE-Tools angesehen und zeigen, wofür sich welches am besten eignet.
Kurz zur Offenlegung: Wir entwickeln ilert AI SRE. Alle Angaben zu den anderen Tools stammen direkt von deren öffentlichen Websites und Dokumentationen und entsprechen dem Stand von November 2026.
AI-SRE-Tools im Überblick
Kurz gesagt
Auf den ersten Blick arbeiten die meisten AI-SRE-Tools gleich: Die Tools lesen Ihre Logs, Metriken und Traces und liefern eine Ursache samt Belegen. Unterschiede gibt es darin, woher ihr Kontext stammt (aus der eigenen Observability-Plattform, aus Ihrem bestehenden Stack oder aus Ihrer Incident-Plattform), wie sie schlussfolgern (über kausale Karten, aktuelle Änderungen oder frühere Incidents), wann sie starten (automatisch, proaktiv oder auf Anfrage) und wie viel sie selbstständig ändern dürfen.
Was macht einen AI SRE aus?
Fast jedes Incident-Management-Tool hat inzwischen KI eingebaut. Meist ist das KI, die bei der Arbeit unterstützt, etwa indem sie den Slack-Channel zusammenfasst, das Status-Update entwirft oder das Postmortem schreibt. Das ist nützlich, aber nicht Thema dieses Artikels.
In diesem Beitrag geht es um AI SREs: KI-Agenten, die innerhalb oder außerhalb Ihrer Plattform für Bereitschaftsmanagement arbeiten, Ihre Logs, Metriken, Traces, Deployments und Ihren Code lesen und bei einem Incident eine Hypothese zur Ursache samt Belegen liefern.
Was wir uns bei jedem Tool angesehen haben
Bei jedem Tool haben wir den AI SRE anhand von vier Kriterien betrachtet:
- Untersuchungstiefe: wie weit das Tool bei der Ursachensuche geht, welche Daten es liest und ob es seine Belege zeigt
- Aktionen und Leitplanken: was es ändern kann und welche Kontrolle Sie darüber haben
- Einbindung in den Workflow: wo die lösung ausgeführt wird, wie es an das Bereitschaftsmanagement integriert ist und ob es mit Ihrem bestehenden Observability-Stack kompatibel ist
- Datenschutz und Sicherheit: welche Zugriffsrechte benötigt werden, wie Ihre Daten verarbeitet werden und welche Modellanbieter sie verarbeiten
Incident-Management-Plattformen mit integriertem AI SRE
Diese Tools bauen den AI SRE direkt in die Plattform ein, die bereits Ihre Alarme, Ihr Bereitschaftsmanagement und Ihre Incidents steuert. Die Untersuchung beginnt also dort, wo auch die Reaktion stattfindet.
ilert AI SRE
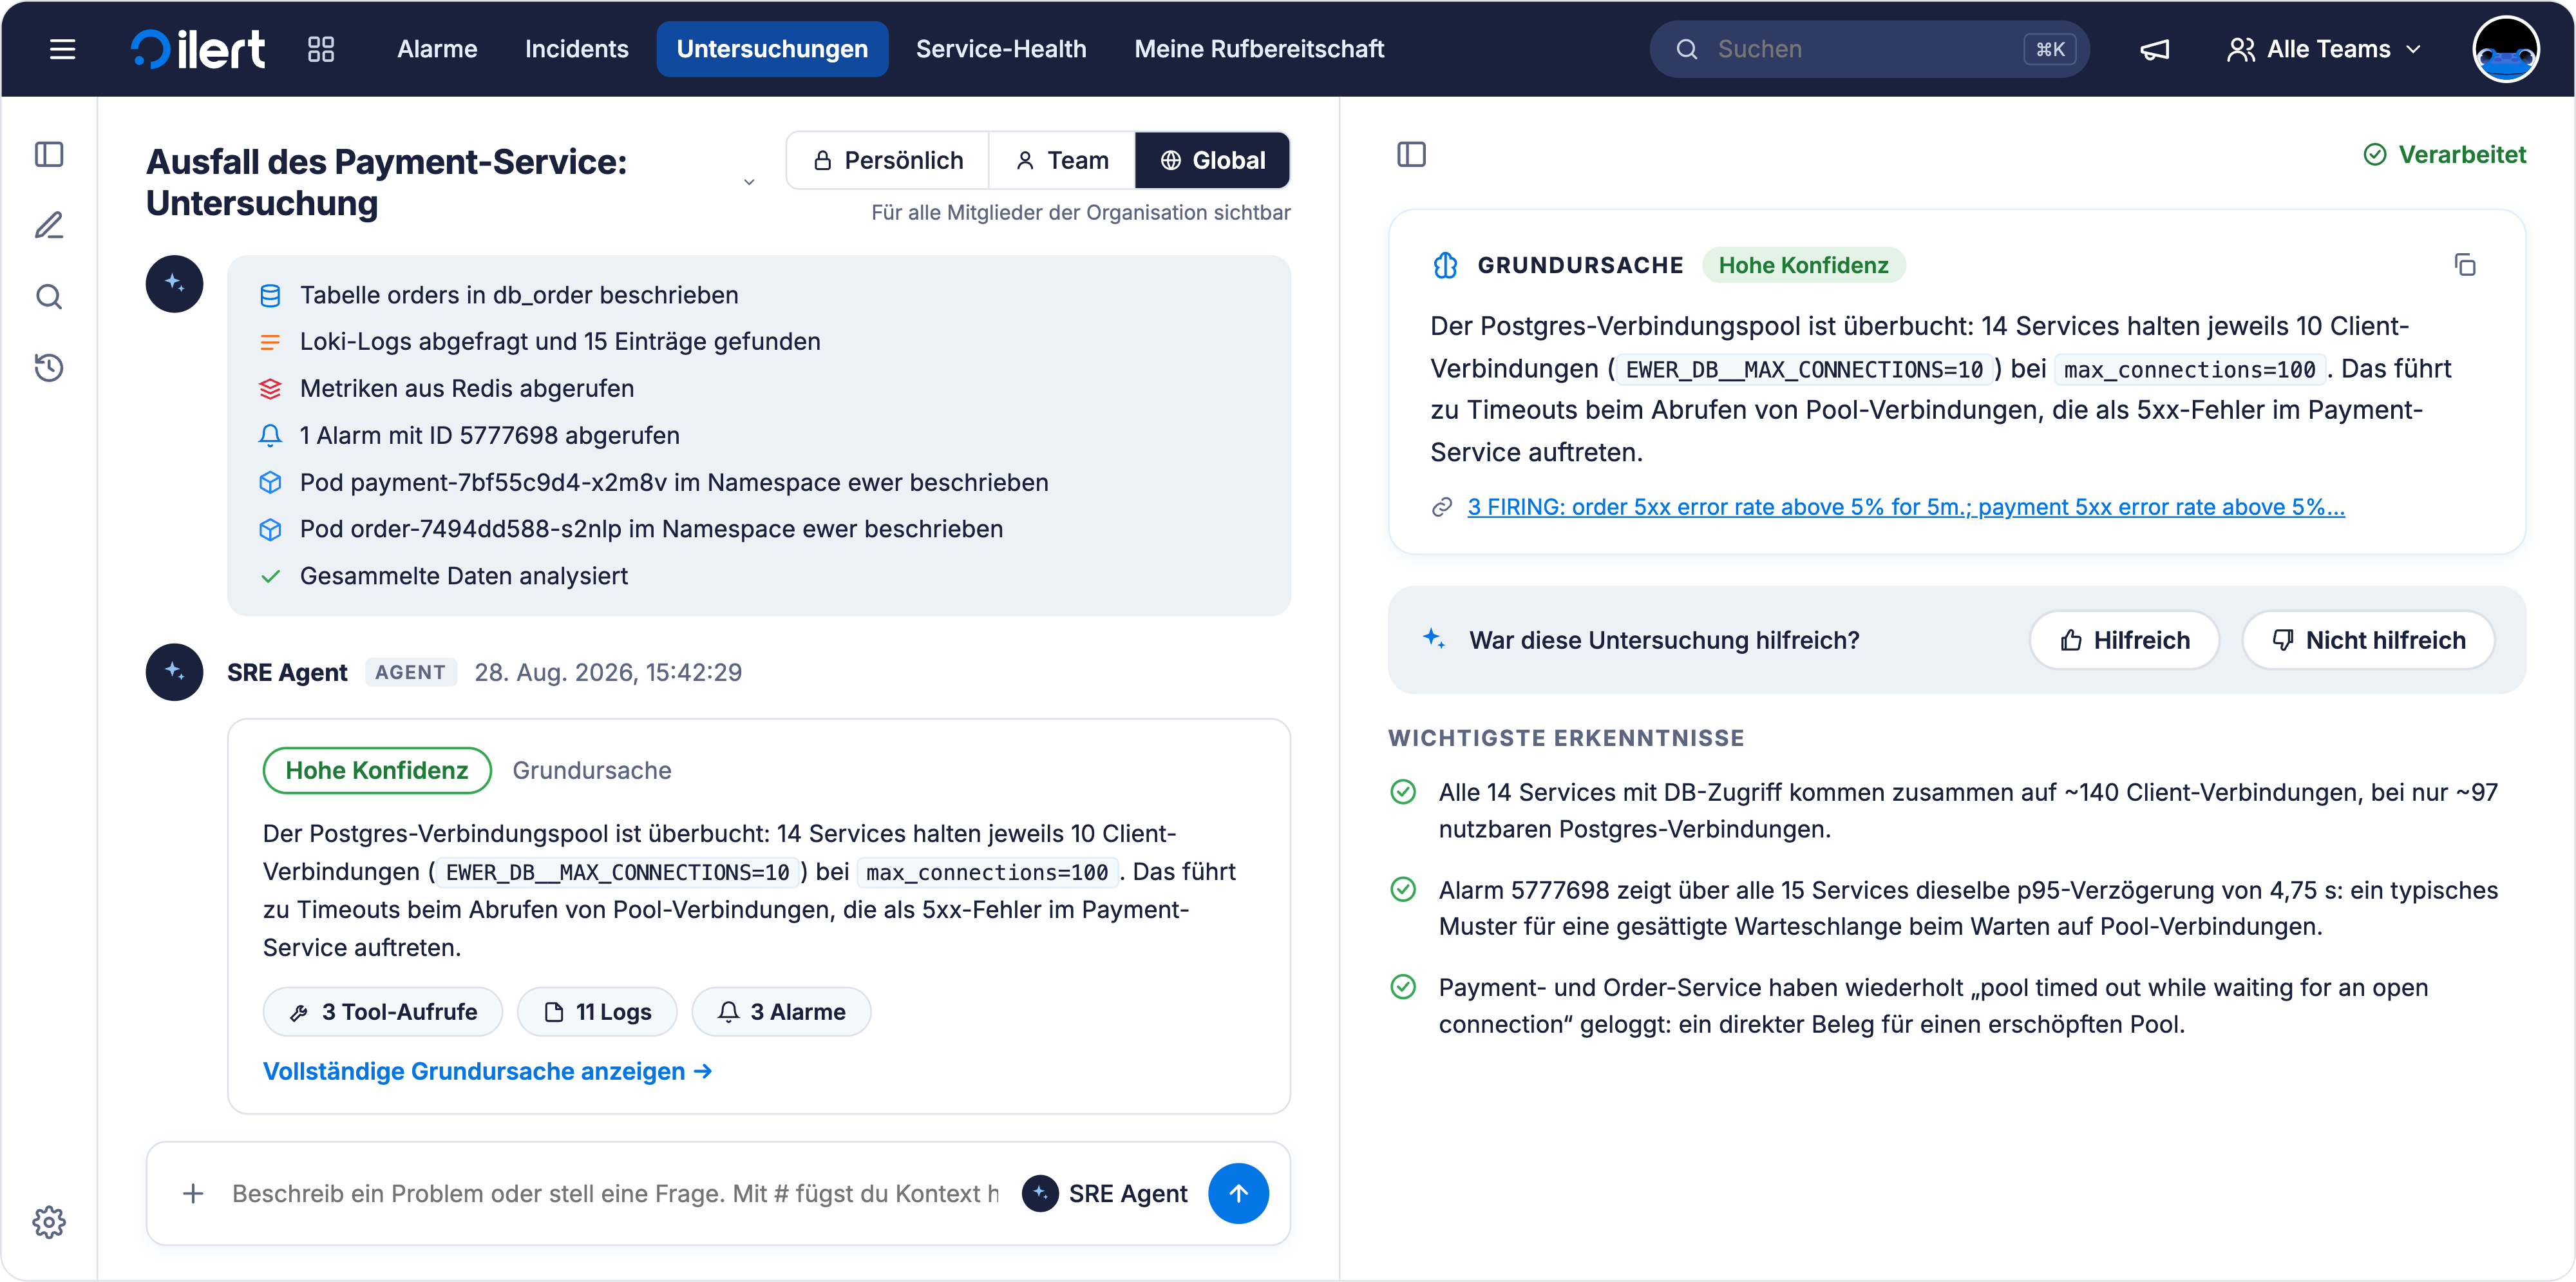
ilert ist eine Incident-Management-Plattform, die Alarmierung, Dienstpläne, Eskalationen, Statusseiten und Postmortems an einem Ort abdeckt, inklusive Mehrkanal-Alarmierung per Push, SMS, Anruf und Chat-Apps. Der AI SRE ist ein Modul dieser Plattform und bringt agentisches Incident-Management in den Workflow, der Ihre Incident Response bereits steuert. Wird ein Alarm ausgelöst, können Sie eine Untersuchung starten: Der AI SRE zieht die relevanten Logs und Metriken heran, korreliert den Alarm mit aktuellen Deployments, Konfigurationsänderungen und dem Zustand der Infrastruktur in Ihren bestehenden Tools und bildet eine Hypothese. Anschließend hängt er einen konkreten Lösungsvorschlag an den laufenden Incident, zusammen mit den Belegen und ähnlichen früheren Incidents. Mit diesen Belegen vor Augen trifft Ihr Engineer die Entscheidung.
Der AI SRE von ilert arbeitet mit reinem Lesezugriff: Er untersucht und schlägt vor, führt aber nichts aus, und jeder Schritt wird protokolliert. Sein Governance-Modell definiert drei Autonomiestufen: L1, Untersuchen und Vorschlagen, ist heute verfügbar; L2, freigegebene Aktionen, und L3, begrenzte Autonomie, sind definiert, aber noch nicht aktiviert. Mehr Autonomie ist eine Einstellung, die Sie einschalten, sobald die Erfahrungswerte das rechtfertigen.
Mit mehr als 150 Integrationen funktioniert ilert mit den Observability-Tools, die Sie bereits nutzen. Weil der AI SRE nativ in der Plattform läuft, die den Responder alarmiert und den Incident steuert, landet sein Vorschlag direkt im laufenden Incident, neben der Information, wer gerade Bereitschaftsdienst hat und wie der Eskalationsstatus ist. Ein Wechsel zwischen Tabs ist nicht nötig.
ilert wird in Deutschland entwickelt, ist DSGVO-konform und nach ISO 27001 zertifiziert, mit Datenresidenz in der EU. Für EU-Kunden läuft der AI SRE in den EU-Regionen von ilert, Frankfurt und Stockholm. Keine Daten verlassen die EU, und nichts wird an die globalen Endpunkte von OpenAI gesendet. ilert hat bei allen KI-Anbietern das Training von Modellen per Opt-out ausgeschlossen. Kunden außerhalb der EU können OpenAI oder AWS nutzen, mit strengen Zugriffskontrollen und Verschlüsselung.
Wann ist ilert AI SRE die richtige Wahl?
Wählen Sie ilert, wenn der AI SRE in der Plattform laufen soll, die Ihre Responder bereits alarmiert. ilert passt gut zu Teams, die eine Plattform statt eines wachsenden Stapels an Add-ons wollen, und zu regulierten Teams in der EU, die KI brauchen, die ihr Security-Team freigibt. Wenn Sie von Opsgenie (Einstellung am 5. April 2027) oder vom archivierten Grafana OnCall wechseln, liest das Migrations-CLI von ilert Ihr bestehendes Setup aus und importiert Benutzer, Teams, Dienstpläne und Eskalationsrichtlinien. So landen Sie direkt auf einer Plattform mit integriertem AI SRE und müssen nicht zweimal migrieren.
Bedenken Sie, dass der AI SRE Fixes derzeit vorschlägt, statt sie anzuwenden. Teams, die vom ersten Tag an vollständig autonome Behebung wollen, sind mit anderen Tools womöglich besser bedient. Für Teams, deren KI sich erst Vertrauen verdienen soll, bevor sie die Produktion anfasst, ist genau das der Punkt. Wie jeder Agent untersucht er außerdem nur, was Sie anbinden. Am besten funktioniert er, sobald Ihre Logs und Metriken angeschlossen sind.
PagerDuty SRE Agent
Der SRE Agent von PagerDuty beginnt mit der Triage von Incidents, die Ihre festgelegten Bedingungen erfüllen, noch bevor jemand sie bestätigt hat. Er fasst die Lage zusammen, zieht Kontext aus verwandten und früheren Incidents sowie aktuellen Änderungen heran und empfiehlt dann eine Aktion oder einen Ihrer bestehenden Workflows. Außerdem können Sie ihn mit eigenen Runbooks füttern und wiederverwendbare „Skills“ definieren, die ihn anleiten.
Wie bei ilert behalten Responder die Kontrolle und geben frei oder übersteuern, was der Agent ausführt. Er läuft in Slack, Microsoft Teams und der PagerDuty-Web-App, direkt auf der On-Call-Plattform von PagerDuty.
Als einer der etabliertesten Incident-Management-Anbieter legt PagerDuty seine Datenrichtlinien offen dar. Kundendaten werden nicht zum Training der Modelle hinter dem SRE Agent verwendet.
Wann ist PagerDuty die richtige Wahl?
Wählen Sie PagerDuty, wenn es bereits tief in einer großen Organisation verankert ist und ein Plattformwechsel unrealistisch ist. Den Agenten hinzuzufügen ist dann die kleinstmögliche Änderung. Bedenken Sie aber, dass er nur in den teureren Tarifen der Reliability Platform von PagerDuty enthalten ist, in denen die KI-Nutzung aus demselben Jahreskontingent an Credits gespeist wird wie Seats und Events.
Vergleichen Sie die beiden Incident-Management-Plattformen: ilert vs. PagerDuty.
Observability-Anbieter
Diese Agenten arbeiten mit den Telemetriedaten, die ihre Plattform bereits speichert. Das gibt ihnen tiefen Kontext innerhalb der Plattform, aber weniger Einblick in alles, was außerhalb passiert.
Datadog Bits AI SRE
Bits AI SRE von Datadog untersucht mit allem, was in Datadog bereits vorliegt: von Metriken, Logs und Traces über Deployments und Quellcode bis zu Database Monitoring und dem Profiler. Bits wägt konkurrierende Hypothesen ab und zeigt jeden Denkschritt in einer Detailansicht.
Wenn es ans Handeln geht, kann Bits Ihr Team in Slack oder Teams benachrichtigen, Incidents und Jira-Tickets anlegen oder über Datadog On-Call einen Responder alarmieren. Admins entscheiden Aktion für Aktion, ob Bits eine Freigabe braucht oder die Aktion gar nicht ausführen darf. Ist eine Freigabe erforderlich, zeichnet ein Responder ab, bevor etwas ausgeführt wird.
Bits läuft in Datadog, Slack und der mobilen App von Datadog und funktioniert am besten, wenn Ihre Daten in Datadog liegen. Die Alarmierung erfolgt über Datadog On-Call, das als separates Produkt verkauft wird.
Der Zugriff auf Bits folgt den rollenbasierten Berechtigungen von Datadog. Als KI-Anbieter nennt Datadog Anthropic und OpenAI.
Wann ist Datadog Bits AI SRE die richtige Wahl?
Wählen Sie Bits, wenn der Großteil Ihrer Telemetriedaten bereits in Datadog liegt. Für Daten in Datadog hat kein anderer Agent von Haus aus so tiefen Kontext. Die Kehrseite: Der Blick von Bits endet weitgehend dort, wo der von Datadog endet. Sind Ihre Daten über mehrere Anbieter verteilt, schrumpft dieser Vorteil, und für die Alarmierung kommt Datadog On-Call als separates Produkt hinzu.
Dynatrace SRE Agent
Dynatrace baut seine Untersuchungen auf Causal AI auf. Mit Smartscape, seinem Echtzeit-Abhängigkeitsgraphen, verfolgt Dynatrace die Spuren über alle Signale hinweg, fasst zusammenhängende Alarme zu einem einzigen Problem zusammen und führt es auf Codeänderungen, Deployments oder Konfigurationsupdates zurück. Sie erhalten eine Ursache, den Blast Radius und einen Lösungsvorschlag.
Danach leitet Dynatrace das Problem ohne manuelle Zuweisung direkt an das Team weiter, dem die betroffene Komponente gehört. Wie viel der SRE Agent selbstständig erledigt, bestimmen Sie. Dynatrace beschreibt ihn als autonom, wenn man es will, und von Menschen freigegeben, wenn es darauf ankommt. Engineers können Fixes vom Smartphone aus freigeben.
Die KI von Dynatrace läuft auf Modellen, die auf Microsoft Azure und AWS Bedrock gehostet werden, und die Anbieter trainieren nicht mit Ihren Prompts. Für Kunden in EMEA findet die KI-Verarbeitung in der EU statt.
Wann ist Dynatrace die richtige Wahl?
Wählen Sie Dynatrace, wenn es bereits Ihre Observability-Plattform ist. Die Agenten von Dynatrace hängen von der eigenen Topologie und den eigenen Daten ab. Innerhalb dieses Ökosystems sind sie daher kaum zu schlagen, Teams mit mehr als einem Observability-Anbieter bekommen aber nur einen Teil des Bildes.
Grafana Assistant Investigations
Die Assistant Investigations von Grafana durchsuchen Ihre Metriken, Logs, Traces und Profile und liefern einen Bericht mit Erkenntnissen, Hypothesen, Belegen mit Quellenangabe und Vorschlägen für nächste Schritte. Nebenbei bauen sie Dashboard-Panels. Anders als einige der oben genannten Tools ändern die Assistant Investigations nichts an Ihren Systemen. Höchstens machen sie aus Erkenntnissen Incident-Updates oder Backlog-Einträge.
Die Investigations laufen in Grafana Cloud und Slack, das Bereitschaftsmanagement übernimmt ein separates Produkt, Grafana IRM.
Der Assistant läuft auf den Claude-Modellen von Anthropic. Grafana speichert Ihren Gesprächsverlauf, nutzt Ihre Daten aber nie zum Training von Modellen, und bei EU-Stacks bleibt die KI-Verarbeitung im EU/EWR-Raum.
Wann ist Grafana Assistant die richtige Wahl?
Wählen Sie den Assistant, wenn Sie bereits auf Grafana Cloud sind und eine Untersuchung wollen, die Ihre Dashboards und Queries versteht. Bedenken Sie: Er berichtet, statt zu handeln, er setzt ein Grafana-Cloud-Konto voraus, auch wenn Sie Grafana selbst hosten, und das Bereitschaftsmanagement ist ein separates Produkt. So schneidet Grafana IRM im Vergleich zu ilert ab.
Metoro
Metoro ist eine Kubernetes-Observability-Plattform mit integriertem AI SRE. Die Plattform sammelt Logs, Metriken, Traces und Profile per eBPF, Codeänderungen sind also nicht nötig. Der Agent von Metoro verknüpft diese Daten mit Kubernetes-Events sowie dem Commit und Pull Request jedes Rollouts, um Ursachen zu finden und Deployments zu prüfen.
Der Agent kann einen Pull Request mit einem Fix öffnen, mergt ihn aber nie, und die KI-Runbooks von Metoro untersuchen, ohne Ihren Cluster anzufassen. Metoro arbeitet aus der eigenen App, aus Slack und über einen MCP-Server und übergibt Alarme an On-Call-Tools wie ilert, statt selbst Personen zu alarmieren.
Als Observability-Plattform speichert Metoro Ihre Telemetriedaten. KI-Funktionen sind Opt-in, und KI-Anbietern ist vertraglich untersagt, mit Ihren Daten zu trainieren. Metoro läuft in der Cloud, in Ihrer eigenen Cloud oder On-Premises.
Wann ist Metoro die richtige Wahl?
Wählen Sie Metoro, wenn Sie auf Kubernetes setzen und Monitoring und KI-Untersuchung in einem Produkt wollen, ohne Code in Ihre Services einzubauen. Der Trade-off: Metoro ist auf Kubernetes fokussiert und bedeutet, Metoro als Observability-Plattform einzuführen. Am besten passt es daher, wenn Sie neu starten oder ohnehin wechseln wollen.
Eigenständige AI-SRE-Agenten
Diese Agenten sind eigenständige Tools, die speziell für die Untersuchung gebaut wurden. Angebunden werden sie an Ihre bestehenden Observability- und On-Call-Tools. Das macht sie flexibel, bedeutet aber auch ein weiteres Tool in Ihrem Incident-Workflow.
Resolve AI
Resolve AI beschreibt sich als Set von Agenten, die stellvertretend für Ihr Team Bereitschaftsdienst übernehmen. Die Agenten triagieren Alarme, führen Root-Cause-Analysen durch, prüfen Deployments und reduzieren die Alarmflut, und Sie können sogar eigene Agenten darauf aufbauen. Wie Dynatrace behebt Resolve das Problem entweder selbst oder eskaliert es an einen Menschen, je nach Ergebnis der Untersuchung.
Die Agenten arbeiten aus der eigenen App und in Slack, decken auch die Alarmierung ab und lassen sich über eine breite Liste von Integrationen anbinden.
Beim Datenschutz gilt: Ihre Telemetriedaten werden live abgefragt statt gespeichert, die Agenten erhalten nur die Zugriffe, die Sie freigeben, und Ihre Daten werden nicht kundenübergreifend zum Training von Modellen genutzt.
Wann ist Resolve AI die richtige Wahl?
Wählen Sie Resolve, wenn Sie einen komplexen Stack mit vielen Anbietern betreiben und einen Agenten wollen, der über alle hinweg angebunden ist, mit Spielraum für eigene Agenten. Bedenken Sie aber, dass Resolve ein weiteres Tool neben Ihren Plattformen für Incident-Management und Observability ist. Ihr Team wechselt während eines Incidents also zwischen ihnen hin und her.
Komodor Klaudia
Klaudia von Komodor ist ein Root-Cause-Agent speziell für Kubernetes. Klaudia deckt alles ab, von fehlgeschlagenen Containern und kaskadierenden Fehlern bis zu Add-ons und CRDs, liefert meist eine Diagnose mit Konfidenzwert und Belegen und erinnert sich an frühere Untersuchungen.
Da Klaudia auch Fixes anwenden kann, lohnt ein genauerer Blick auf die Leitplanken von Komodor. Jeder Agent auf der Plattform läuft mit denselben rollenbasierten Berechtigungen wie Ihre menschlichen Nutzer, und der Zugriff ist pro Integration und pro Umgebung begrenzt. Für jede Art von Aktion legen Sie fest, ob sie erlaubt, gesperrt oder zur Freigabe zurückgehalten wird, und jeder Schritt wird protokolliert.
Klaudia finden Sie in Komodor, mit Integrationen für Slack, Teams, MCP und IDEs. Ausgelöst wird Klaudia von Ihrem On-Call-Tool.
Bei Zugangsdaten gilt: Agenten halten nie einen offenliegenden Schlüssel, sondern erhalten zur Laufzeit eingeschränkten Zugriff aus einem zentralen Credential Store.
Wann ist Komodor Klaudia die richtige Wahl?
Wählen Sie Klaudia, wenn die meisten Ihrer Incidents in Kubernetes entstehen. Beginnen Ihre Incidents oft außerhalb des Clusters, etwa in einer Datenbank, einer Drittanbieter-API oder einer Deploy-Pipeline, sieht ein universeller Agent mehr vom Gesamtbild.
Traversal
Traversal baut ein sogenanntes „Production World Model“, eine kausale Karte Ihrer Systeme, die aus Ihren bestehenden Observability-Tools gespeist wird. Traversal verarbeitet Produktionsdaten laufend im Hintergrund, sodass die Vorarbeit erledigt ist, wenn etwas kaputtgeht. Laut Traversal kann die kausale Suche eine Ursache über mehr als zehn Hops hinweg verfolgen, von Anwendungen bis hinunter ins Netzwerk.
Die KI-Agenten von Traversal, Workers genannt, treten dem Incident-Channel selbstständig bei, entscheiden, wann sie eingreifen, und führen die Untersuchung von Anfang bis Ende durch. Bis es etwas zu melden gibt, bleiben sie still.
Workers laufen nativ in Slack und Microsoft Teams. Über den MCP-Server von Traversal können Engineers es außerdem aus Claude Code, Cursor oder ChatGPT aufrufen.
Jede Integration hat nur Lesezugriff, Observability-Daten werden nach einer Untersuchung nicht aufbewahrt, und Ihre Daten werden nicht zum Training von Modellen für andere Kunden genutzt. Traversal läuft als SaaS, Single-Tenant oder in Ihrer eigenen Cloud.
Wann ist Traversal die richtige Wahl?
Wählen Sie Traversal, wenn Sie im Enterprise-Maßstab arbeiten und einen Agenten wollen, der über die Services vieler Teams hinweg selbstständig mit der Untersuchung beginnt. Gut passt Traversal auch für regulierte Teams, die es in ihrer eigenen Cloud betreiben wollen. Für kleinere Teams ist es womöglich mehr als nötig, und wie andere eigenständige Agenten kommt es als weiteres Tool neben Ihre On-Call-Plattform.
Cleric
Cleric richtet seine Untersuchungen auf Änderungen aus. Nach jedem Merge prüft Cleric die Änderung 14 Tage lang gegen den Live-Traffic, schließt Fehlalarme und geht den echten Alarmen nach. Dabei greift es auf Quellen wie Datadog, Prometheus, Grafana, Kubernetes, Sentry und GitHub zurück.
Findet Cleric eine Ursache, kann es einen Pull Request mit einem Fix öffnen und bestätigen, dass sich der Service erholt hat. Es startet aber mit reinem Lesezugriff, bekommt Schreibzugriff erst, wenn Sie so weit sind, und Engineers geben jeden Fix frei. Cleric arbeitet aus der eigenen App, aus Slack und über MCP, liest den Incident-Kontext aus PagerDuty und überlässt Alarmierung und Eskalationen PagerDuty.
Bei den Modellen setzt Cleric auf Anthropic, Google Gemini und OpenAI unter vertraglichen No-Training-Bedingungen und fragt rohe Logs und Metriken live ab, statt sie zu speichern.
Wann ist Cleric die richtige Wahl?
Wählen Sie Cleric, wenn Sie einen Agenten wollen, der arbeitet, bevor der Pager losgeht, nicht erst danach. Cleric beobachtet die Produktion nach jedem Deployment weiter und schließt Fehlalarme selbstständig. Damit passt es gut zu Teams, die häufig ausliefern. Da Cleric Alarmierung und Eskalationen Ihrem On-Call-Tool überlässt, betreiben Sie es weiterhin neben Ihrer Incident-Plattform.
Zusammenfassung
AI-SRE-Tools unterscheiden sich weniger darin, ob sie eine Ursache finden, als darin, wo sie laufen, was sie ändern dürfen und was dabei mit Ihren Daten passiert. Liegen Ihre Telemetriedaten bei einem einzigen Observability-Anbieter, hat dessen Agent den tiefsten Kontext. Ist Ihr Stack über mehrere Tools verteilt, sieht ein Agent, der an alle angebunden ist, oder einer, der in Ihre Incident-Plattform integriert ist, mehr vom Gesamtbild. Und egal, wofür Sie sich entscheiden: Prüfen Sie, wie viel der Agent selbstständig tun darf und wohin Ihre Daten gehen, bevor Sie ihn in der Produktion einschalten.
Erleben Sie ilert AI SRE an Ihren eigenen Incidents. Jetzt kostenlos testen.
FAQ
Was ist ein AI-SRE-Tool?
Ein KI-Agent, der Produktions-Incidents untersucht. Er liest Ihre Logs, Metriken, Traces, Deployments und Ihren Code und liefert eine Hypothese zur Ursache samt Belegen. Das unterscheidet ihn von KI-Funktionen, die Texte zusammenfassen oder entwerfen.
Mit welchen Daten sollte ein AI SRE verbunden sein?
Beginnen Sie mit Metriken, Logs und Traces sowie einem Feed mit Deployments und Konfigurationsänderungen. Die meisten der oben genannten Tools finden Ursachen, indem sie einen Alarm mit einer aktuellen Änderung verknüpfen. Ergänzen Sie dann Quellcode und Pull Requests, den Zustand der Infrastruktur wie Kubernetes-Events sowie frühere Incidents und Runbooks. Ein Agent kann nur untersuchen, was er sieht, jede Lücke in seinem Zugriff wird also zu einer Lücke in seinen Ergebnissen. Starten Sie mit reinem Lesezugriff, beschränkt auf die Umgebungen, die er untersuchen muss.
Welche AI-SRE-Tools sind in eine Plattform für Bereitschaftsmanagement integriert?
Mehrere AI-SRE-Tools stammen von Anbietern, die auch Bereitschafts- und Incident-Management anbieten. Die Untersuchung findet dann dort statt, wo auch Alarmierung und Eskalationen laufen. ilert und PagerDuty sind Beispiele dafür.
Welche AI-SRE-Tools halten Daten in der EU?
Mehrere Anbieter bieten EU-Verarbeitung für ihre KI-Funktionen an. ilert betreibt KI-Workloads in seinen EU-Regionen (Frankfurt und Stockholm), Grafana hält die KI-Verarbeitung bei EU-Stacks im EU/EWR-Raum, und Dynatrace verarbeitet KI-Anfragen von Kunden in EMEA in der EU. Cleric bietet eine Hosting-Option in der EU an, allerdings können manche Betriebsdaten die EU trotzdem verlassen. Traversal und Metoro lassen sich in Ihrer eigenen Cloud betreiben, sodass Sie die Region selbst wählen. Egal, welches Tool Sie prüfen: Achten Sie darauf, wo die KI-Verarbeitung stattfindet, nicht nur, wo Ihre Daten gespeichert sind.
Was sollte ich einen Anbieter zum Datenschutz fragen?
Fragen Sie, welche Zugriffe der Agent braucht, ob er Ihre Telemetriedaten speichert, ob Ihre Daten für das Training genutzt werden, welche Modellanbieter sie verarbeiten und wo.