Alarmierung, Bereitschaftsmanagement und Incident Response – mit einem AI SRE, der untersucht und die Lösung vorschlägt. Entwickelt und gehostet in Deutschland.
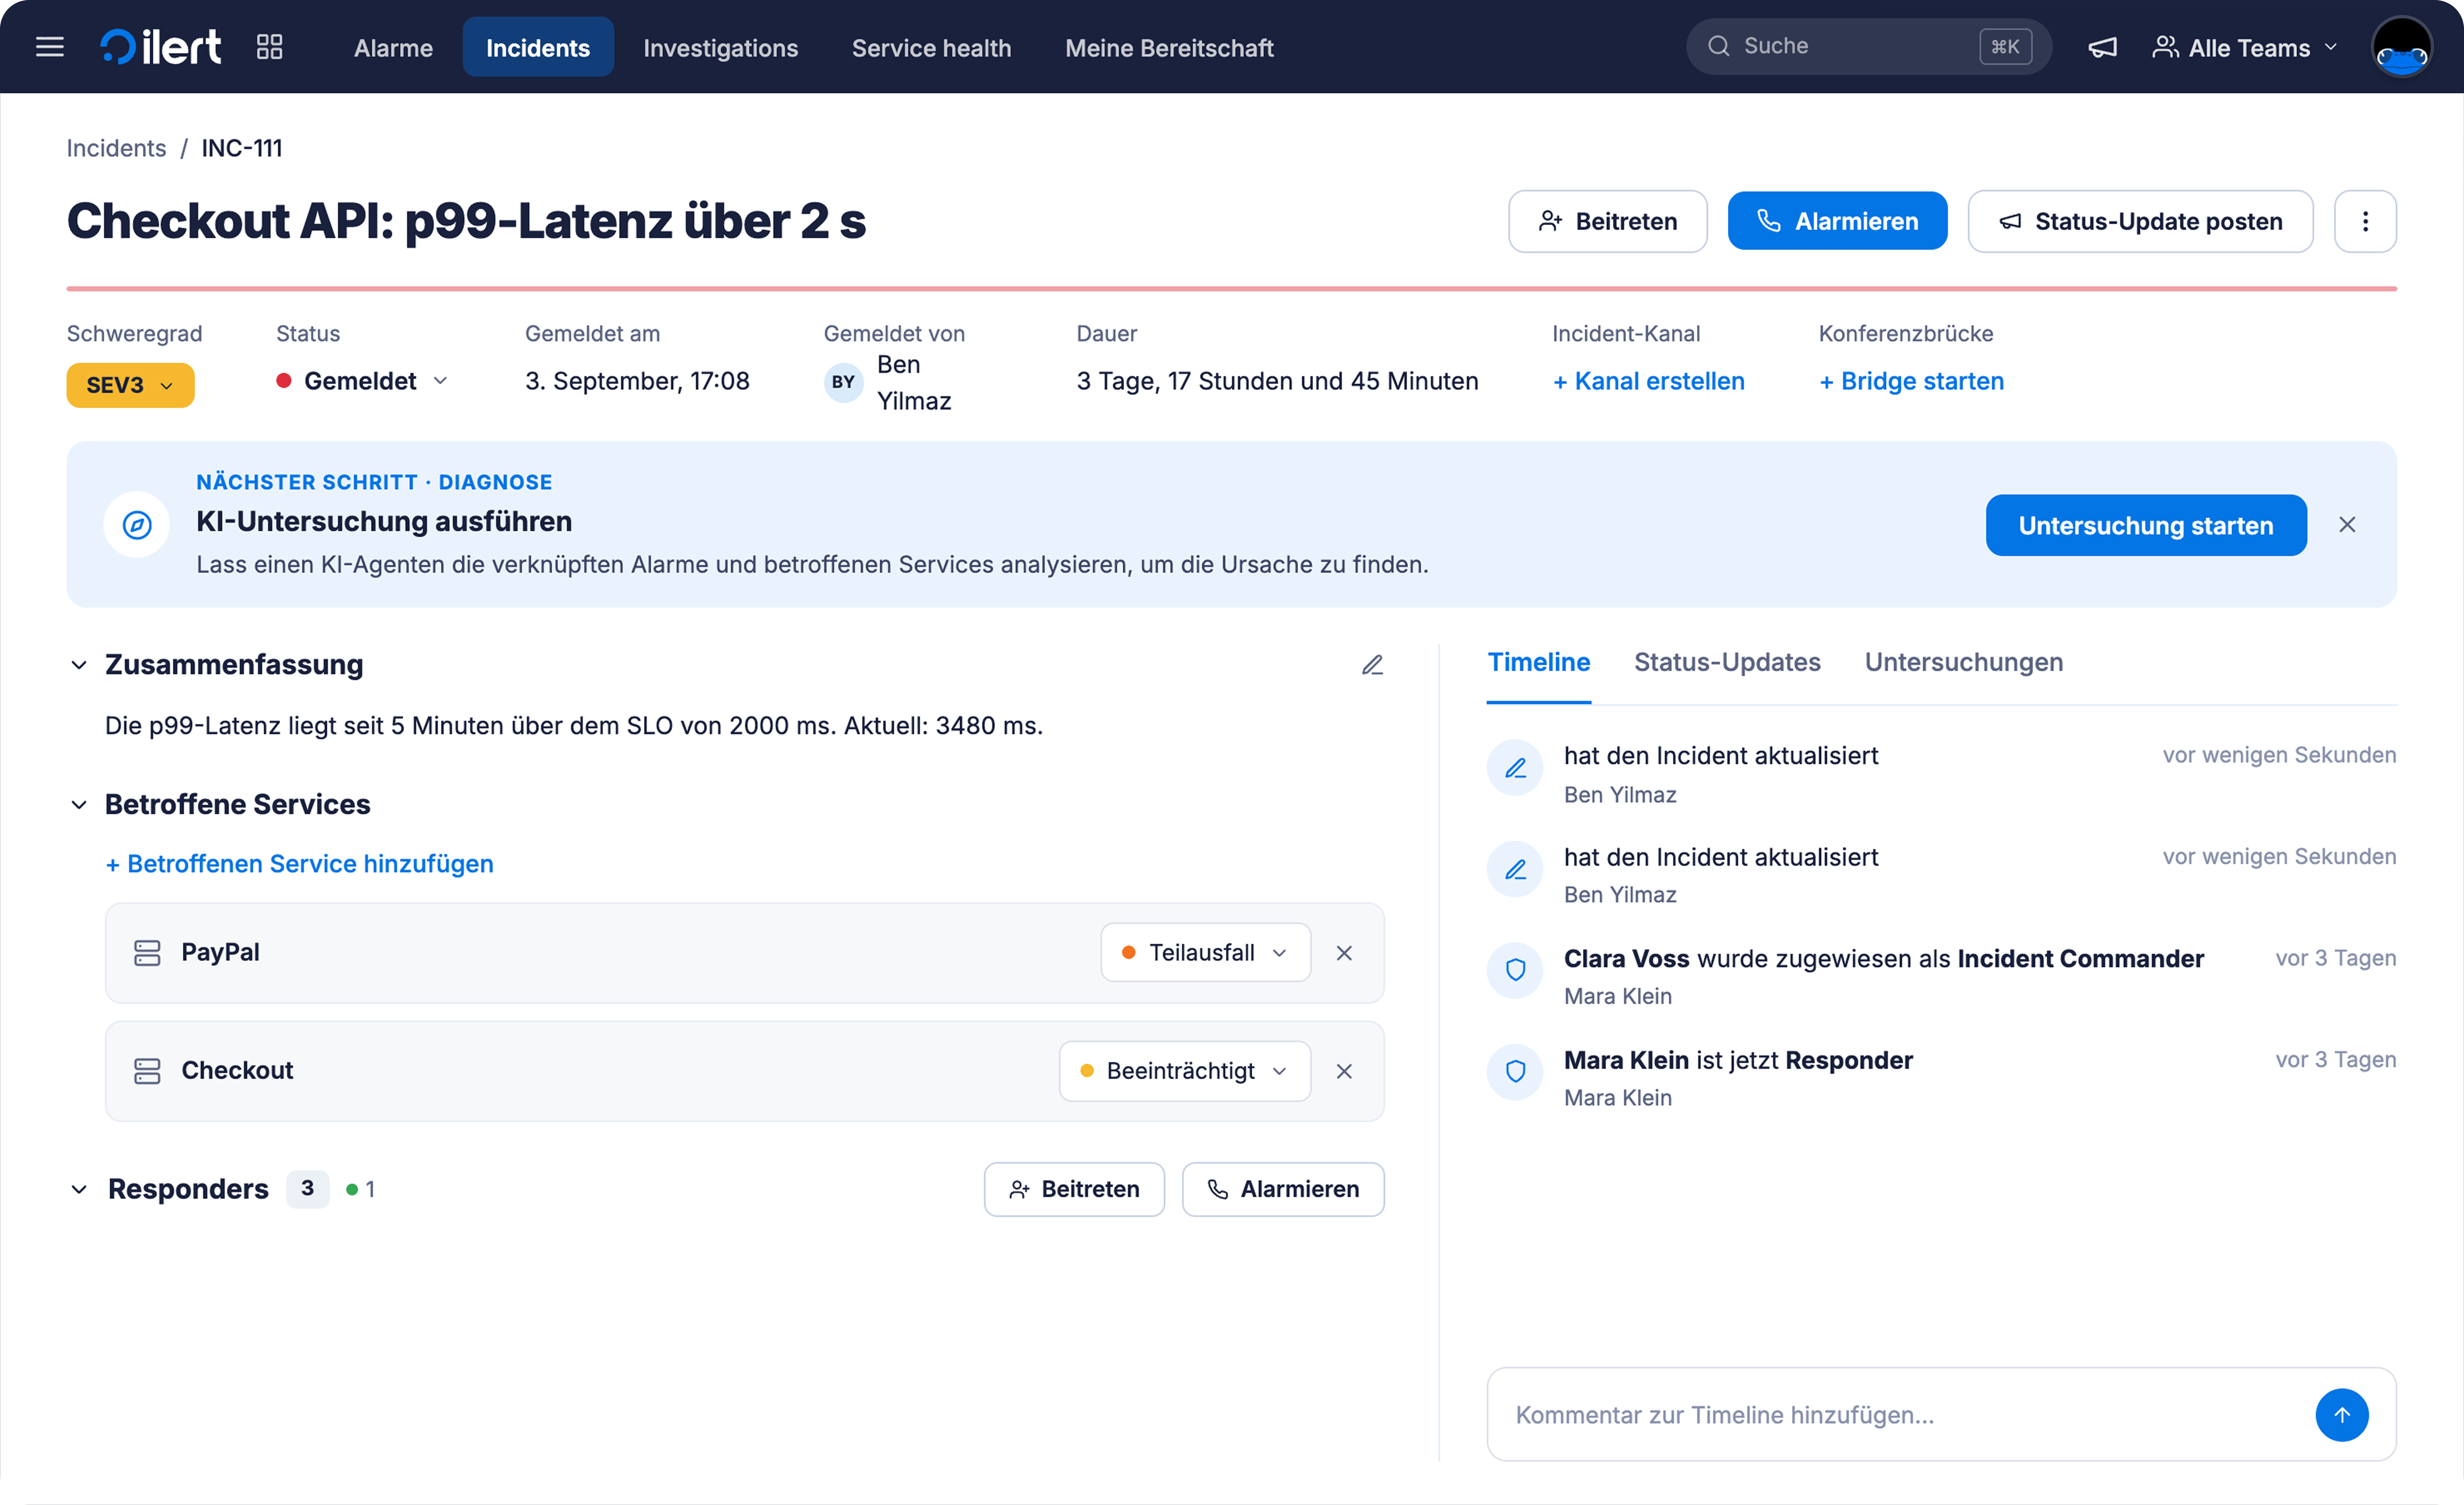
Ein Workspace für die gesamte Incident Response. Legen Sie den Schweregrad fest, starten Sie parallele Eskalationen und bestimmen Sie einen Incident Commander.
Veröffentlichen Sie Status-Updates aus demselben Tool, das Sie auch zur Reaktion nutzen – auf öffentlichen, privaten oder zielgruppenspezifischen Seiten.
ilert stellt mithilfe unserer vorgefertigten Integrationen oder per E-Mail eine nahtlose Verbindung zu Ihren Tools her. ilert lässt sich in Überwachungs-, Ticketing-, Chat- und Kollaborationstools integrieren.
So erreichen führende Unternehmen mit ilert eine Uptime von 99,9 %
Unternehmen weltweit vertrauen auf ilert, um ihr Incident-Management zu optimieren, die Zuverlässigkeit zu steigern und Ausfallzeiten zu minimieren. Lesen Sie, was unsere Kunden über ihre Erfahrungen mit unserer Plattform sagen.
Am 27. Juli 2026 trat der Digital Omnibus on AI, die Verordnung (EU) 2026/1744, in Kraft und änderte den Zeitplan des EU AI Act. Die Anforderungen für Hochrisiko-KI-Systeme, die ursprünglich ab dem 2. August 2026 gelten sollten – darunter die Meldepflicht für schwerwiegende Vorfälle gemäß Artikel 73 –, gelten nun erst ab dem 2. Dezember 2027 für eigenständige Hochrisiko-KI-Systeme (Anhang III) und ab dem 2. August 2028 für KI-Systeme, die in regulierte Produkte integriert sind (Anhang I).
Nicht alles wurde verschoben: Seit dem 2. August 2026 gelten die Transparenzpflichten nach Artikel 50, und die Kommission kann gegen Anbieter von KI-Modellen mit allgemeinem Verwendungszweck Geldbußen verhängen. Die seit August 2025 geltenden Verpflichtungen für GPAI – einschließlich der Meldepflicht für schwerwiegende Vorfälle bei Modellen mit systemischem Risiko – bleiben unverändert in Kraft.
Aufgeschoben, aber nicht aufgehoben. Die zusätzlichen 16 Monate sind das Zeitfenster, um die Meldung schwerwiegender Vorfälle in die eigenen Betriebsprozesse zu integrieren – und kein Grund, das Thema auf Eis zu legen. Im Folgenden erklären wir, was sich geändert hat, was unverändert bleibt und was Ihr Incident-Prozess künftig leisten muss.
Was durch den Digital Omnibus geändert wurde
Die Europäische Kommission legte den Digital Omnibus on AI am 19. November 2025 vor, nachdem deutlich geworden war, dass das Compliance-Ökosystem nicht rechtzeitig zum ursprünglich vorgesehenen Stichtag im August 2026 bereit sein würde: Die Ausarbeitung der harmonisierten Normen von CEN-CENELEC verzögerte sich, Konformitätsbewertungsstellen waren noch nicht benannt, und viele Mitgliedstaaten hatten ihre Marktüberwachungsbehörden noch nicht eingerichtet. Parlament und Rat erzielten am 7. Mai 2026 eine politische Einigung und verabschiedeten den Text im Juni formell. Er wurde am 24. Juli 2026 im Amtsblatt der Europäischen Union veröffentlicht. Drei Tage später trat die Verordnung in Kraft – sechs Tage vor der ursprünglich vorgesehenen Frist.
Ein Detail ist für die Planung besonders wichtig: Die neuen Termine sind fest und nicht an Bedingungen geknüpft. Der ursprüngliche Vorschlag der Kommission machte den Aufschub noch davon abhängig, ob Normen und Leitlinien rechtzeitig vorliegen würden; 2027 beziehungsweise 2028 waren lediglich als späteste Termine vorgesehen. Parlament und Rat ersetzten dieses Modell durch feste Stichtage. Dr. Nils Rauer von Pinsent Masons bezeichnete die Einigung als „einen pragmatischen Schritt hin zu mehr Rechtssicherheit“. Es gibt damit kein Szenario, in dem die Verpflichtungen früher greifen, und auch kein realistisches Szenario, in dem sie erneut verschoben werden.
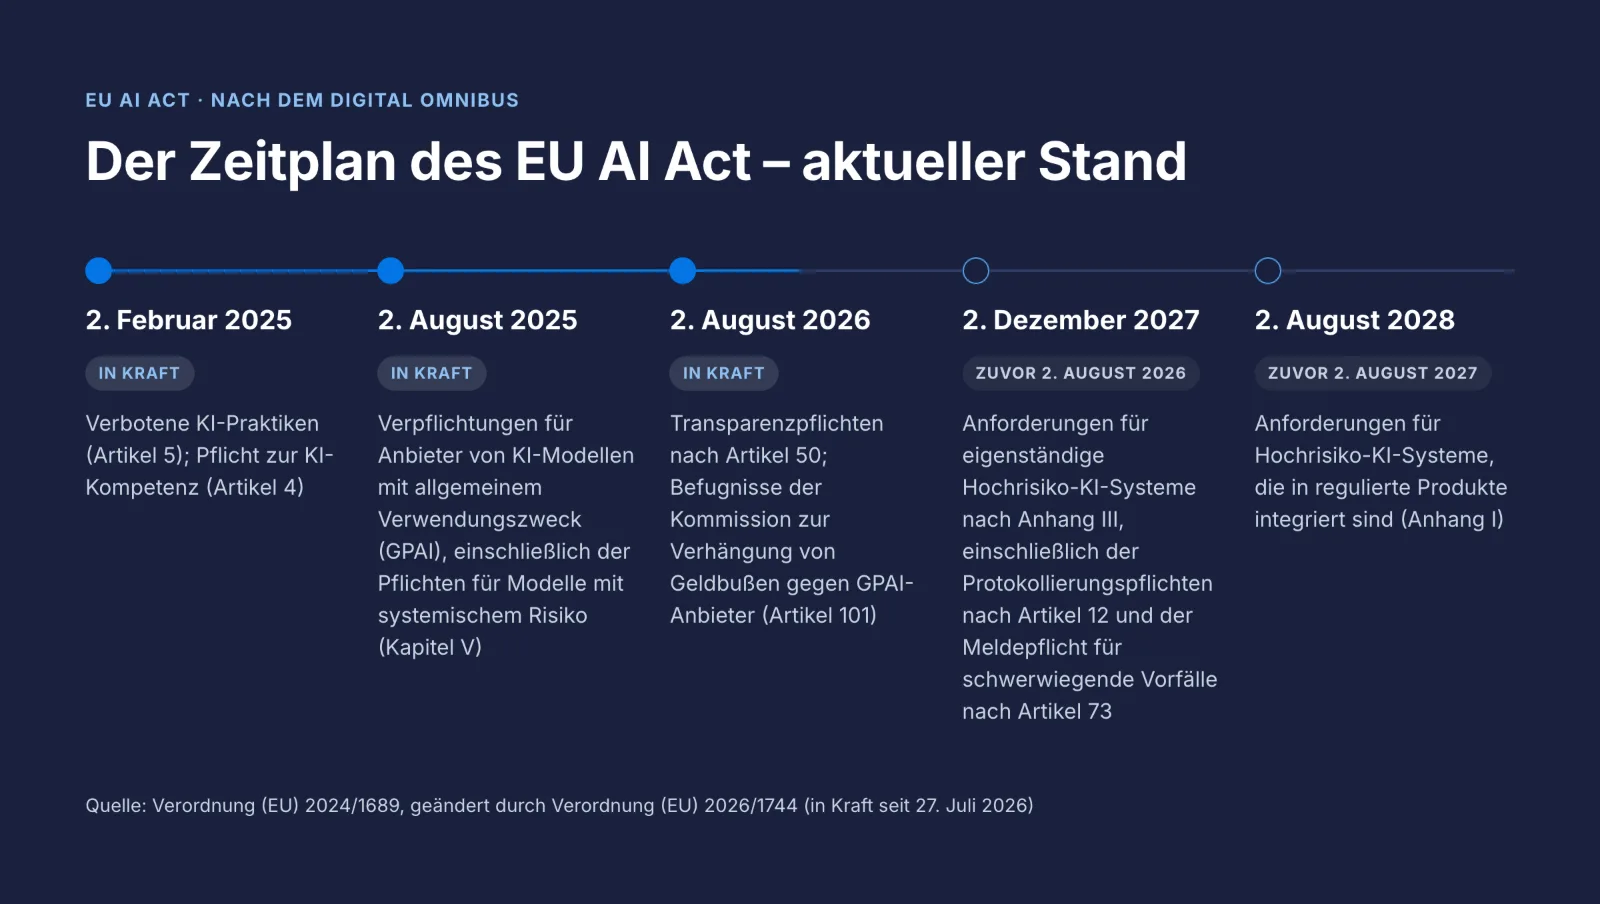
Der Zeitplan des EU AI Act – aktueller Stand
2. Februar 2025 (in Kraft): Verbotene KI-Praktiken (Artikel 5); Pflicht zur KI-Kompetenz (Artikel 4)
2. August 2025 (in Kraft): Verpflichtungen für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck (GPAI), einschließlich der Pflichten für Modelle mit systemischem Risiko (Kapitel V)
2. August 2026 (in Kraft): Transparenzpflichten nach Artikel 50; Befugnisse der Kommission zur Verhängung von Geldbußen gegen GPAI-Anbieter (Artikel 101)
2. Dezember 2027: Anforderungen für eigenständige Hochrisiko-KI-Systeme nach Anhang III, einschließlich der Protokollierungspflichten nach Artikel 12 und der Meldepflicht für schwerwiegende Vorfälle nach Artikel 73
2. August 2028: Anforderungen für Hochrisiko-KI-Systeme, die in regulierte Produkte integriert sind (Anhang I)
Was für 2026 schon gilt, unabhängig vom Fristaufschub
Wenn Sie KI-Systeme in der EU entwickeln oder einsetzen, sind zwei Punkte bereits jetzt relevant:
Transparenzpflichten (Artikel 50, seit dem 2. August 2026): Nutzer müssen darüber informiert werden, wenn sie mit einem KI-System interagieren. KI-generierte oder manipulierte Inhalte müssen zudem gekennzeichnet und maschinell erkennbar sein. Dabei handelt es sich nicht um eine Pflicht im Zusammenhang mit Incidents, wohl aber um eine der ersten Verpflichtungen aus dem EU AI Act, auf deren Einhaltung viele Engineering-Teams tatsächlich geprüft werden dürften.
Durchsetzung der GPAI-Vorschriften (seit dem 2. August 2026): Die Transparenz-, Dokumentations- und Urheberrechtspflichten für GPAI-Anbieter gelten bereits seit August 2025. Neu ist die Befugnis der Kommission, bei Verstößen Geldbußen von bis zu 3 % des weltweiten Jahresumsatzes oder 15 Millionen Euro zu verhängen – je nachdem, welcher Betrag höher ist. Für Anbieter von GPAI-Modellen mit systemischem Risiko wird die Erfassung und Meldung schwerwiegender Vorfälle bereits nach Artikel 55 Absatz 1 Buchstabe c verlangt. Der Code of Practice sieht dabei Meldefristen vor, die denen aus Artikel 73 entsprechen, sowie eine Frist von fünf Tagen für schwerwiegende Cybersicherheitsvorfälle.
Artikel 73: Anforderungen an die Meldung schwerwiegender Vorfälle
Artikel 73 enthält die zentralen Vorgaben des EU AI Act für die Meldung schwerwiegender Vorfälle. Gerade bei den Fristen lohnt es sich, genau hinzusehen: Häufig wird fälschlicherweise von einer 72-Stunden-Regel nach dem Vorbild der DSGVO ausgegangen. Für Anbieter von Hochrisiko-KI-Systemen gelten tatsächlich folgende Fristen:
Unverzügliche Meldung, nachdem ein ursächlicher Zusammenhang zwischen dem KI-System und dem Vorfall oder die hinreichende Wahrscheinlichkeit eines solchen Zusammenhangs festgestellt wurde, und spätestens innerhalb von 15 Tagen, nachdem der Anbieter von einem schwerwiegenden Vorfall Kenntnis erlangt hat.
Spätestens innerhalb von 2 Tagen bei einem weitverbreiteten Verstoß oder einer schwerwiegenden und irreversiblen Beeinträchtigung kritischer Infrastrukturen.
Spätestens innerhalb von 10 Tagen, wenn eine Person infolge des Vorfalls verstorben ist.
Ein „schwerwiegender Vorfall“ ist ein Vorfall oder eine Fehlfunktion, die direkt oder indirekt zum Tod oder zu einer schwerwiegenden Gesundheitsschädigung, zu einer schwerwiegenden und irreversiblen Beeinträchtigung kritischer Infrastrukturen, zu einem Verstoß gegen Verpflichtungen zum Schutz der Grundrechte oder zu schwerwiegenden Schäden an Eigentum oder Umwelt führt.
Drei operative Aspekte sind für Engineering-Teams besonders wichtig:
Ein unvollständiger Erstbericht ist ausdrücklich zulässig und kann später durch einen vollständigen Bericht ergänzt werden. Die Verordnung geht davon aus, dass die Meldung erfolgt, während die Untersuchung noch läuft. Der Meldeprozess darf daher nicht davon abhängen, dass das Postmortem bereits abgeschlossen ist.
Sie müssen den Vorfall untersuchen, das Risiko bewerten und Korrekturmaßnahmen ergreifen: Bevor die zuständigen Behörden informiert wurden, darf das KI-System zudem nicht so verändert werden, dass dies die Bewertung der Ursachen des Vorfalls beeinträchtigen könnte. Die Beweiskette muss also auch während der Incident Response erhalten bleiben.
Auch Betreiber sind eingebunden: Nach Artikel 26 Absatz 5 muss ein Betreiber, der einen schwerwiegenden Vorfall feststellt, unverzüglich den Anbieter informieren und anschließend gegebenenfalls den Importeur oder Händler sowie die Marktüberwachungsbehörden. Kommunikationswege zwischen Anbieter und Betreiber sind damit ein Bestandteil der Compliance und kein optionales Extra.
Die Kommission hat bereits einen Entwurf für Leitlinien sowie eine standardisierte Meldevorlage zu Artikel 73 veröffentlicht; die endgültigen Fassungen stehen noch aus. Zugleich sieht der EU AI Act selbst bereits vor, Doppelmeldungen zu vermeiden: Fällt ein Hochrisiko-KI-System unter eine sektorspezifische Regelung mit gleichwertigen Meldepflichten – etwa kritische Infrastrukturen unter NIS2 oder Medizinprodukte unter der MDR –, beschränken Artikel 73 Absätze 9 und 10 die Meldepflicht nach dem EU AI Act auf Vorfälle, die Grundrechte betreffen. Alle anderen Vorfälle werden nach den jeweiligen sektorspezifischen Vorschriften gemeldet.
Kurz gesagt: Ein gut aufgesetzter Incident-Prozess kann die Anforderungen mehrerer Aufsichtsregime gleichzeitig abdecken.
Warum jetzt handeln – und nicht erst im November 2027?
Es spricht vieles dafür, den Aufschub aktiv zu nutzen, statt ihn einfach verstreichen zu lassen:
Die Termine stehen jetzt fest: Feste Stichtage haben die Unsicherheit beseitigt, die ein Abwarten bislang noch rechtfertigen konnte.
Die Anforderungen betreffen vor allem operative Abläufe – nicht bloß Dokumentationspflichten: Manipulationssichere Protokollierung, bereichsübergreifende Benachrichtigung, Beweissicherung und Melden während einer laufenden Untersuchung sind operative Fähigkeiten. Teams, die solche Abläufe erst im vierten Quartal 2027 einführen, werden unter erheblichem Zeitdruck stehen.
Wer sie bereits jetzt etabliert und erprobt, gewinnt dagegen rund ein Jahr praktische Erfahrung.
Der gleiche Prozess zahlt sich schon heute in anderen Regelwerken aus: Die 24-Stunden-Frühwarnung und die 72-Stunden-Meldung nach NIS2, die 72-Stunden-Frist der DSGVO für Datenschutzverletzungen sowie die Incident-Meldepflichten nach DORA folgen jeweils eigenen Zeitvorgaben – und keine davon wurde verschoben. Ein einheitlicher Incident-Prozess mit automatischer Fristenverfolgung, rollenbasierten Eskalationen und auditfähigen Postmortems kann mehrere regulatorische Anforderungen mit derselben Dokumentations- und Beweisgrundlage abdecken.
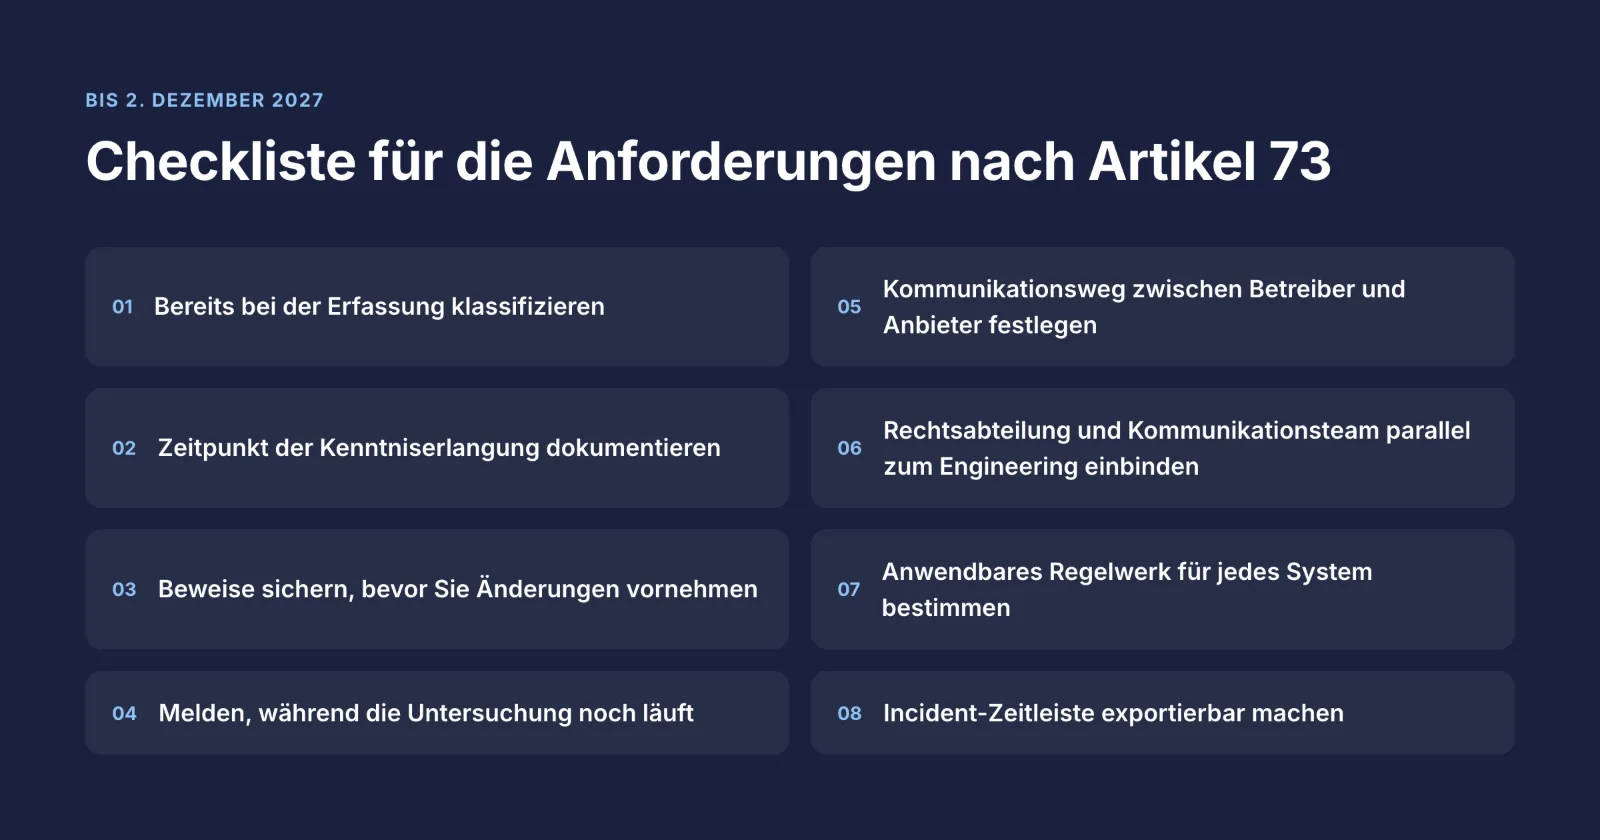
Checkliste für die Anforderungen nach Artikel 73
Was Ihr Incident-Prozess bis Dezember 2027 leisten können muss – und was sich bereits heute im Hinblick auf NIS2, DORA und DSGVO auszahlt:
Bereits bei der Erfassung klassifizieren: Im Rahmen der Triage muss geprüft werden, ob ein Vorfall die Definition eines „schwerwiegenden Vorfalls“ nach Artikel 3 Nummer 49 erfüllen könnte. So wird die Frist nach dem EU AI Act vom ersten Tag an berücksichtigt – und nicht erst beim Postmortem.
Zeitpunkt der Kenntniserlangung dokumentieren: Die Fristen von 2, 10 beziehungsweise 15 Tagen beginnen mit dem Zeitpunkt, zu dem Sie von dem Vorfall Kenntnis erlangen. Dieser Zeitpunkt sollte automatisch erfasst werden, anstatt ihn später zu rekonstruieren zu müssen.
Beweise sichern, bevor Sie Änderungen vornehmen: Bis die Behörden informiert sind, dürfen keine Änderungen am KI-System vorgenommen werden, die die Ursachenanalyse beeinträchtigen könnten (Artikel 73 Absatz 6). Logs, Modellversionen und Eingabedaten müssen daher während der Incident Response erhalten bleiben.
Melden, während die Untersuchung noch läuft: Ein unvollständiger Erstbericht ist zulässig. Der Meldeprozess darf daher nicht auf die abschließende Ursachenanalyse warten.
Kommunikationsweg zwischen Betreiber und Anbieter festlegen: Betreiber müssen Anbieter unverzüglich informieren (Artikel 26 Absatz 5). Kommunikationskanal und Vorlage sollten deshalb im Voraus festgelegt werden.
Rechtsabteilung und Kommunikationsteam parallel zum Engineering einbinden: Die Person, die die Meldung einreicht, ist in der Regel nicht dieselbe Person, die den Incident behebt.
Anwendbares Regelwerk für jedes System bestimmen: Es muss klar sein, welche Frist greift – nach EU AI Act, NIS2, DORA oder DSGVO – oder ob eine sektorspezifische Regelung die Meldepflicht nach Artikel 73 Absätze 9 und 10 ersetzt.
Incident-Zeitleiste exportierbar machen: Jede Meldung erfordert eine nachvollziehbare Dokumentation. Sie sollte direkt aus den aufgezeichneten Ereignissen erstellt werden können – und nicht nachträglich aus dem Gedächtnis.
Checkliste für die Anforderungen nach Artikel 73
So unterstützt ilert die Incident-Meldepflichten des EU AI Act
ilert macht Sie nicht automatisch EU-AI-Act-konform – das kann kein Tool. Es sorgt jedoch dafür, dass die operativen Anforderungen zu festen Abläufen werden, statt im Ernstfall zu einem Heldeneinsatz zu werden:
Auditfähige Zeitleisten (Artikel 12, Artikel 73 Absatz 6): Jede Alarmierung, Eskalation, Bestätigung und Maßnahme wird automatisch in der Incident-Zeitleiste erfasst und kann exportiert werden. So entsteht eine belastbare Dokumentation über die gesamte Dauer des Incidents, ohne dass während einer Störung ein Teammitglied parallel alles manuell protokollieren muss.
Meldeprozesse innerhalb der vorgegebenen Fristen (2/10/15 Tage):Multi-Channel-Alarmierung, Dienstpläne und Eskalationsrichtlinien sorgen dafür, dass Incidents innerhalb weniger Minuten erkannt und an die richtigen Personen weitergeleitet werden. Die eigentliche Herausforderung von Artikel 73 ist nicht die Meldefrist selbst, sondern dass Ursachenanalyse und Dokumentation rechtzeitig vorliegen. Automatisierte Zeitleisten und KI-gestützte Postmortems erzeugen einen Großteil dieser Dokumentation direkt im Zuge der Incident Response.
Bereichsübergreifende Abläufe (Artikel 26 Absatz 5, Artikel 73 Absatz 1): Playbooks binden Engineering, Rechtsabteilung und Kommunikationsteam parallel ein. Statusseiten versorgen Stakeholder mit verifizierten Updates, ohne die Responder durch zusätzliche Meetings von der Incident Response abzuhalten.
Von Monitoring zu Incident (Artikel 55 Absatz 1 Buchstabe c, Artikel 72): Werden in Ihrem Monitoring-Stack Schwellenwerte überschritten, treten Output-Drift, erhöhte Inferenzfehler oder ungewöhnliche Verzögerungen auf, kann über die Alarmierungsquellen von ilert automatisch ein Incident eröffnet werden. So laufen Post-Market-Monitoring und Incident-Tracking auf derselben Datengrundlage.
Datenverarbeitung auf EU-Niveau: ilert wird in Deutschland entwickelt und gehostet, ist nach ISO 27001 zertifiziert und DSGVO-konform. Auch die KI-Inferenz bleibt innerhalb der Region. So schafft das Tooling für die Reaktion auf KI-Incidents keine zusätzlichen Risiken beim Datentransfer.
Governance statt unkontrollierter Autonomie: Ein zentrales Prinzip des EU AI Act ist die menschliche Aufsicht über KI. ilert AI SRE folgt demselben Grundsatz: Der Agent untersucht, korreliert und erstellt Entwürfe; ein Responder prüft die Ergebnisse und entscheidet über die nächsten Schritte. Die KI übernimmt die Analyse. Die Entscheidung liegt beim Menschen.
Teilweise. Der Digital Omnibus on AI (Verordnung (EU) 2026/1744, in Kraft seit dem 27. Juli 2026) verschob die Anforderungen für Hochrisiko-KI-Systeme auf den 2. Dezember 2027 (Anhang III) beziehungsweise den 2. August 2028 (Anhang I). Die Verpflichtungen für GPAI sowie die Transparenzpflichten nach Artikel 50 blieben bei ihren ursprünglich vorgesehenen Terminen.
Welche Bestimmungen gelten seit dem 2. August 2026?
Die Transparenzpflichten nach Artikel 50 sowie die Befugnis der Kommission, gegen GPAI-Anbieter Geldbußen zu verhängen. Die GPAI-Verpflichtungen selbst – einschließlich der Meldepflicht für schwerwiegende Vorfälle bei Modellen mit systemischem Risiko – waren zu diesem Zeitpunkt bereits in Kraft.
Ab wann gilt die Meldepflicht für schwerwiegende Vorfälle nach Artikel 73?
Die Meldepflicht ist an die Anforderungen für Hochrisiko-KI-Systeme gekoppelt: Sie gilt ab dem 2. Dezember 2027 für eigenständige Systeme nach Anhang III und ab dem 2. August 2028 für in regulierte Produkte integrierte Systeme nach Anhang I. Für GPAI-Modelle mit systemischem Risiko gilt bereits eine parallele Meldepflicht nach Artikel 55 Absatz 1 Buchstabe c.
Wie schnell müssen schwerwiegende Vorfälle nach dem EU AI Act gemeldet werden?
Unverzüglich, sobald ein ursächlicher Zusammenhang – oder dessen hinreichende Wahrscheinlichkeit – festgestellt wurde, und spätestens innerhalb von 15 Tagen nach Kenntniserlangung. Bei weitverbreiteten Verstößen oder einer schwerwiegenden Beeinträchtigung kritischer Infrastrukturen gilt eine Frist von 2 Tagen, bei einem Todesfall von 10 Tagen. Es gilt also keine 72-Stunden-Frist – diese stammt aus der DSGVO.
Hat der Aufschub Auswirkungen auf NIS2, DORA oder die DSGVO?
Nein. Diese Regelwerke und ihre jeweiligen Meldefristen bleiben unverändert. Das umfassendere Digital-Omnibus-Paket sieht zwar Änderungen an der DSGVO und NIS2 vor, diese befinden sich zum Zeitpunkt der Veröffentlichung jedoch noch in Verhandlung und sind noch nicht geltendes Recht. Der EU AI Act selbst sieht für die meisten Incidents bei sektorspezifisch regulierten Systemen vor, dass die Meldung nach den jeweiligen sektorspezifischen Vorschriften erfolgt (Artikel 73 Absätze 9 und 10). Ein einheitlicher Incident-Prozess ist daher die sinnvollste Lösung, um mehrere regulatorische Anforderungen abzudecken.
Dieser Artikel bietet praktische Hinweise zur Gestaltung von Incident-Prozessen und stellt keine Rechtsberatung dar.
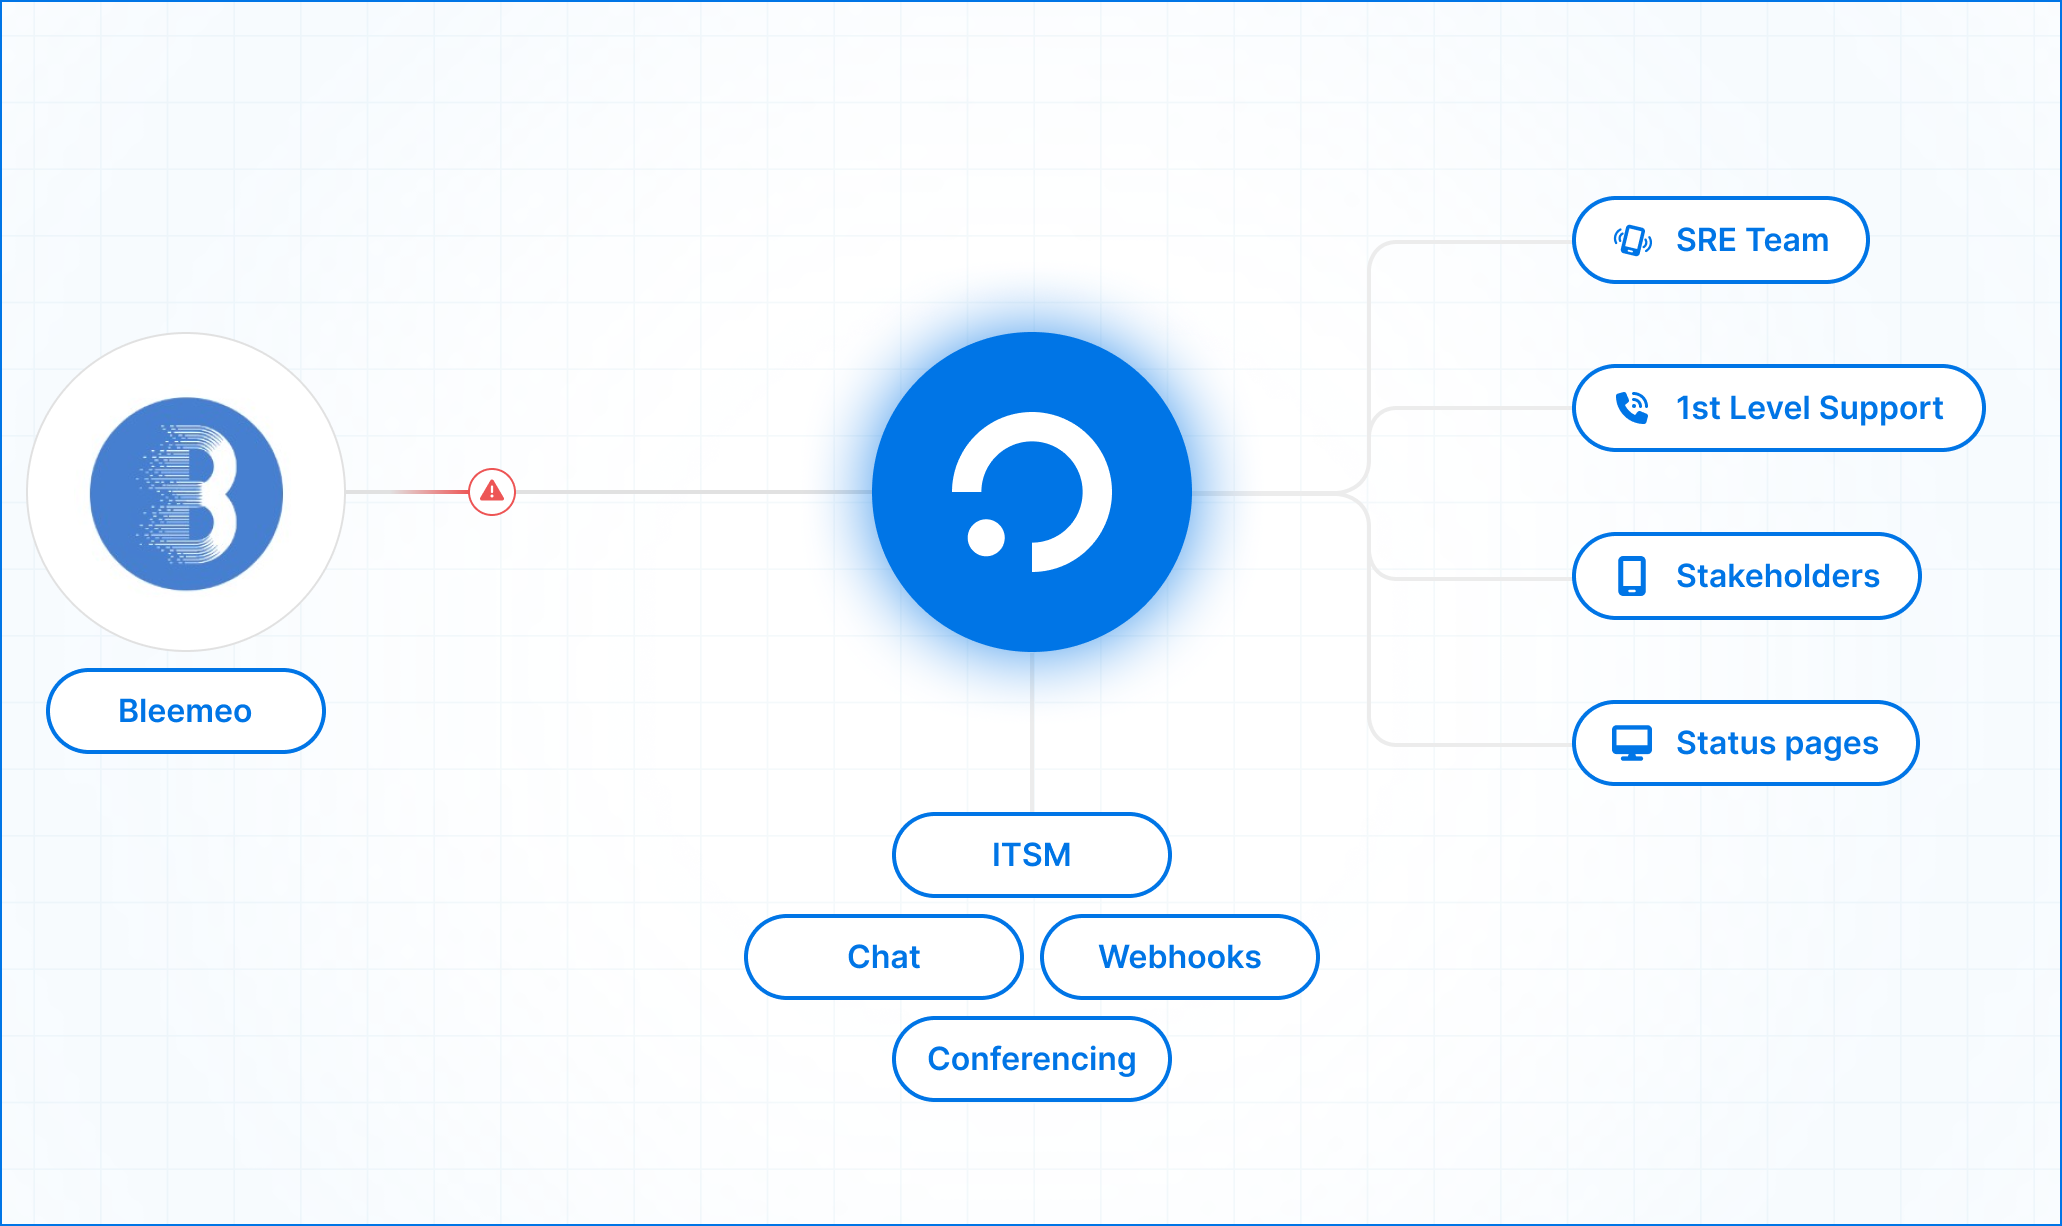
Bleemeo-Monitoring lässt sich jetzt nativ mit ilert verbinden und koppelt die Schwellenwert-Erkennung an Bereitschaftsmanagement und Alarmierung. DevOps-, SRE- und IT-Betriebsteams bekommen einen direkten Weg vom überschrittenen Schwellenwert zum Telefon der Person, die das Problem beheben kann – und zurück zu einem sauberen Zustand, sobald es behoben ist.
Was ist Bleemeo?
Bleemeo ist eine Cloud-Monitoring-Plattform für Server, Docker-Container, Kubernetes-Cluster, AWS- und Azure-Ressourcen, VMware-Umgebungen und SNMP-Netzwerkgeräte – alles in einer SaaS-Konsole. Hinzu kommen Uptime-Checks, Application Performance und Logs, sodass Teams ihre IT-Infrastruktur und die darauf laufenden Services an einem Ort im Blick behalten.
Die Datenerfassung läuft über Glouton, den Open-Source-Agenten von Bleemeo. Die Alarmregeln arbeiten schwellenwertbasiert mit getrennten Warning- und Critical-Stufen; wer feiner steuern möchte, formuliert Bedingungen in PromQL.
Warum Bleemeo mit ilert verbinden?
Bleemeo erkennt zuverlässig, dass etwas nicht stimmt. Was danach passiert – wer geweckt wird, über welchen Kanal und was folgt, wenn niemand reagiert – übernimmt ilert.
Sobald die Integration aktiv ist, sendet Bleemeo seine Benachrichtigungen an eine dedizierte Alarmquelle in ilert. Von dort wendet ilert Ihre Eskalationsrichtlinie und Ihren Dienstplan an und erreicht die diensthabende Person per Push, SMS, Sprachanruf oder Chat – mit automatischer Eskalation, wenn niemand bestätigt.
Die Alarmierung ist dabei erst der Anfang. Aus demselben Alarm kann ein deklarierter Incident mit eigenem Kanal und Incident Commander werden, ein Update Ihrer Statusseite für Kunden und ein Postmortem, sobald er geschlossen ist.
Zwei Details zählen im Alltag. Erstens löst sich der Alarm automatisch auf: Sobald das Problem in Bleemeo behoben ist, schließt ilert den zugehörigen Alarm. Was offen ist, spiegelt damit den realen Zustand Ihrer Systeme wider und nicht einen Rückstand, den jemand aufräumen muss. Zweitens erfolgt die Gruppierung pro überwachter Metrik, bei Agent-Events pro Agent. Wiederholte Benachrichtigungen zum selben Problem aktualisieren den bestehenden Eintrag, statt neue anzulegen – ein strauchelnder Host weckt Sie also einmal, nicht fünfzigmal.
Zwei europäische Plattformen, eine Alarmierungskette
Bleemeo ist ein französisches Unternehmen, 2015 in Toulouse gegründet, und speichert Metriken und Logs in der EU. ilert ist ein deutsches Unternehmen aus Köln, gehostet in EU-Rechenzentren und ISO 27001-zertifiziert. Für Teams unter DSGVO-, NIS2- oder DORA-Anforderungen heißt das: eine Kette vom Monitoring bis zur Alarmierung, in der beide Vertragspartner europäischem Recht unterliegen – ein Subprozessor-Gespräch weniger im Security-Review.
Integration in drei Schritten einrichten
Verbinden Sie beide Systeme in drei Schritten:
In ilert:
Öffnen Sie Alarmquellen und legen Sie eine neue an
Suchen Sie nach Bleemeo und wählen Sie es aus
Vergeben Sie einen Namen, weisen Sie Teams zu, wählen Sie eine Eskalationsrichtlinie und legen Sie Ihre Gruppierung fest
Schließen Sie die Einrichtung ab und kopieren Sie den Integrationsschlüssel
In Bleemeo:
Öffnen Sie Administration → Integrations und klicken Sie auf Add Integration
Wählen Sie ilert, fügen Sie den Schlüssel ein und vergeben Sie einen sprechenden Namen wie „Production On-Call“
Alarme routen:
Gehen Sie zu Notifications und legen Sie eine neue Regel an oder bearbeiten Sie eine bestehende
Wählen Sie im Schritt Targets Ihre ilert-Integration aus
Da ilert eine eigens gebaute Alarmquelle für Bleemeo mitbringt, ist kein Field-Mapping nötig. Die Alarme fließen eingehend von Bleemeo nach ilert, und die Einrichtung dauert insgesamt wenige Minuten.
Die vollständige Schritt-für-Schritt-Anleitung finden Sie auf docs.ilert.com. Bei Problemen hilft Ihnen unser Support-Team unter support@ilert.com.
Wenn Sie um 3 Uhr nachts alarmiert werden, dauert es etwa 30 Sekunden, bis die Benachrichtigung Sie erreicht, und dann noch zwei Minuten, bis Sie vor dem Laptop sitzen und wach genug sind, um sie zu lesen. Was Sie dann sehen, ist meist eine “nackte” Alarmierung: eine Metrik, ein Schwellenwert, ein Link zu einem Dashboard. Dann beginnt das übliche Ritual: Dashboard öffnen, prüfen, was in den letzten Stunden bereitgestellt wurde, die Logs nach dem ersten Fehler durchsuchen und in Slack fragen, ob jemand Änderungen an der Datenbank vorgenommen hat.
Die meiste Zeit entfällt bei einem Incident auf die Suche nach der Ursache. Sobald die Nadel im Heuhaufen gefunden ist, geht die eigentliche Behebung meist schnell – und häufig ist ein Rollback schon ausreichend. Es ist die Suche, die Sie 20, 45 oder manchmal sogar 60 Minuten Ihrer Nacht kostet.
Die Zielvorgabe für den ilert AI SRE war einfach: Wenn Sie Ihren Laptop öffnen, sollte die Fehlersuche bereits abgeschlossen sein. Vor etwa einem Jahr haben wir die geschlossene Beta gestartet – damals noch unter dem Namen ilert Responder – zunächst mit einigen wenigen Teams. Seitdem haben wir den Agenten dreimal neu aufgebaut. Jede dieser Überarbeitungen hat uns neue Erkenntnisse gebracht: wo ein Agent tatsächlich hilft, wie ein gutes technisches Gerüst aussieht und was „produktionsreif“ bedeutet, wenn der Agent gemeinsam mit Ihnen Bereitschaftsdienst hat.
Jetzt ist der ilert AI SRE in allen kostenpflichtigen Tarifen sowie während der Testphase allgemein verfügbar.
Was macht der AI SRE?
Geben Sie dem AI SRE eine Alarmierung aus einer unserer mehr als 150 Integrationen, und er beginnt mit der Analyse – im Grunde so, wie Sie selbst vorgehen würden, nur schneller. Er prüft Logs, Metriken und Traces. Außerdem untersucht er, was sich geändert hat, denn Änderungen sind die häufigste Ursache für Incidents: Deployments, Konfigurationsänderungen, zusammengeführte Pull Requests und – sofern Sie Ihr Repository angebunden haben – sogar den tatsächlichen Diff.
Wenn 50 Alarmierungen gleichzeitig eingehen, führt der AI SRE zunächst eine Triage durch, fasst sie zu Clustern zusammen und untersucht anschließend jedes Cluster separat.
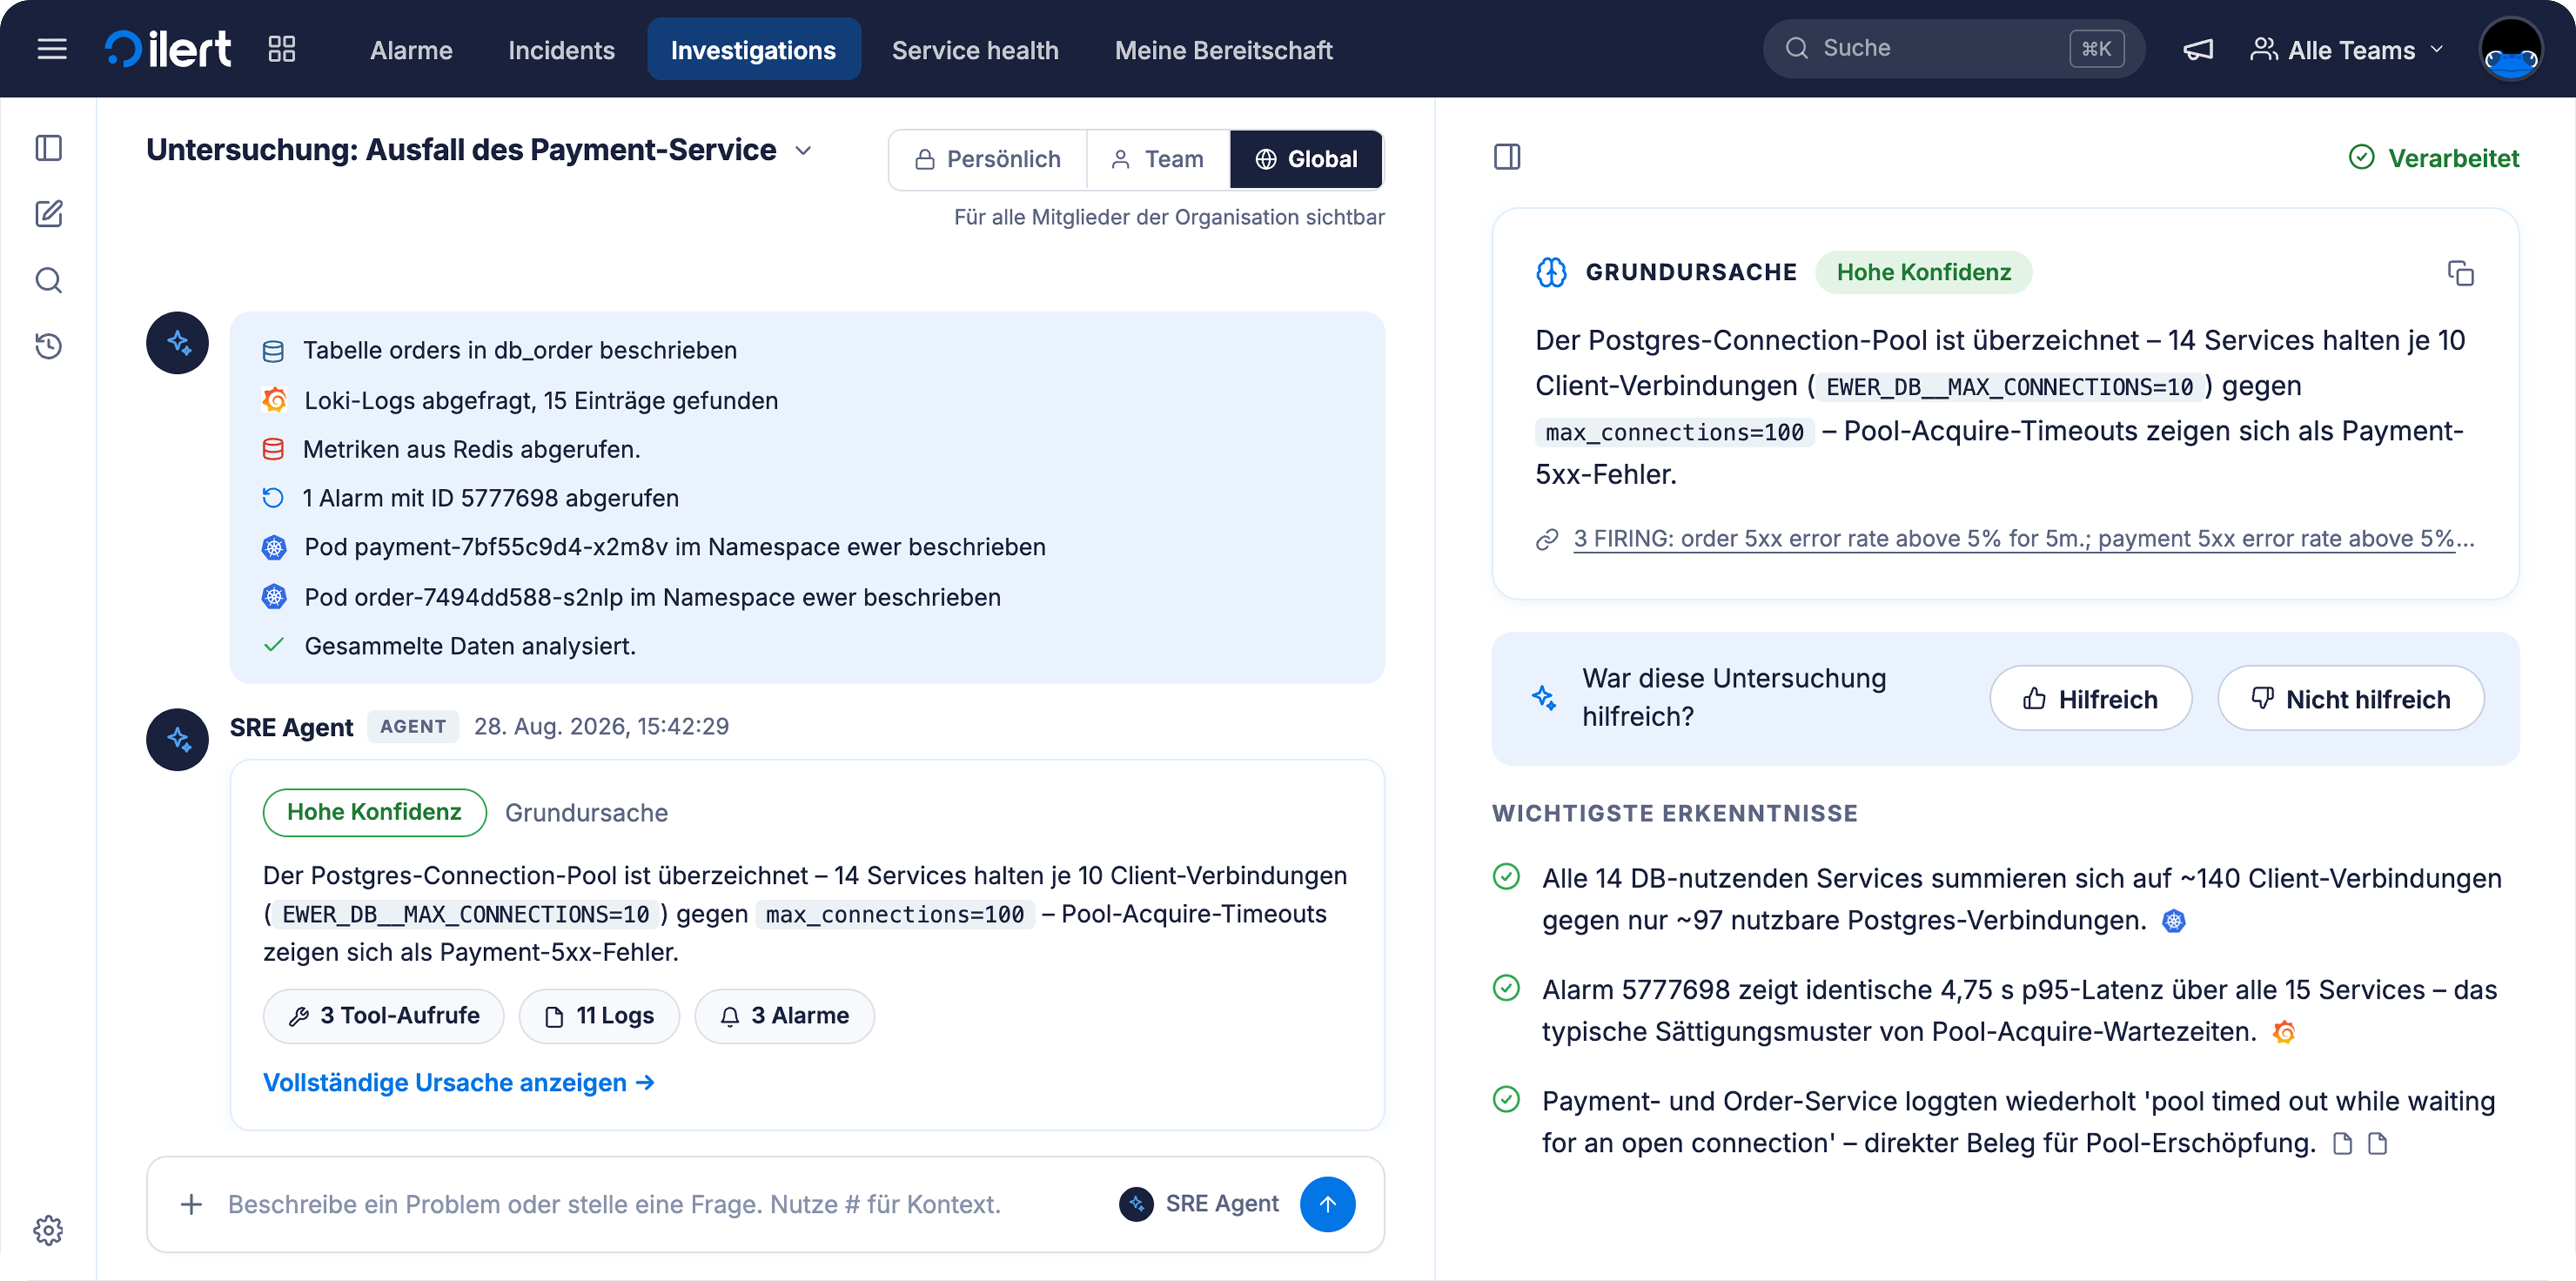
Ein paar Minuten später sehen Sie nicht nur eine reine Alarmierung – stattdessen liegt Ihnen bereits eine Root-Cause-Analyse vor.
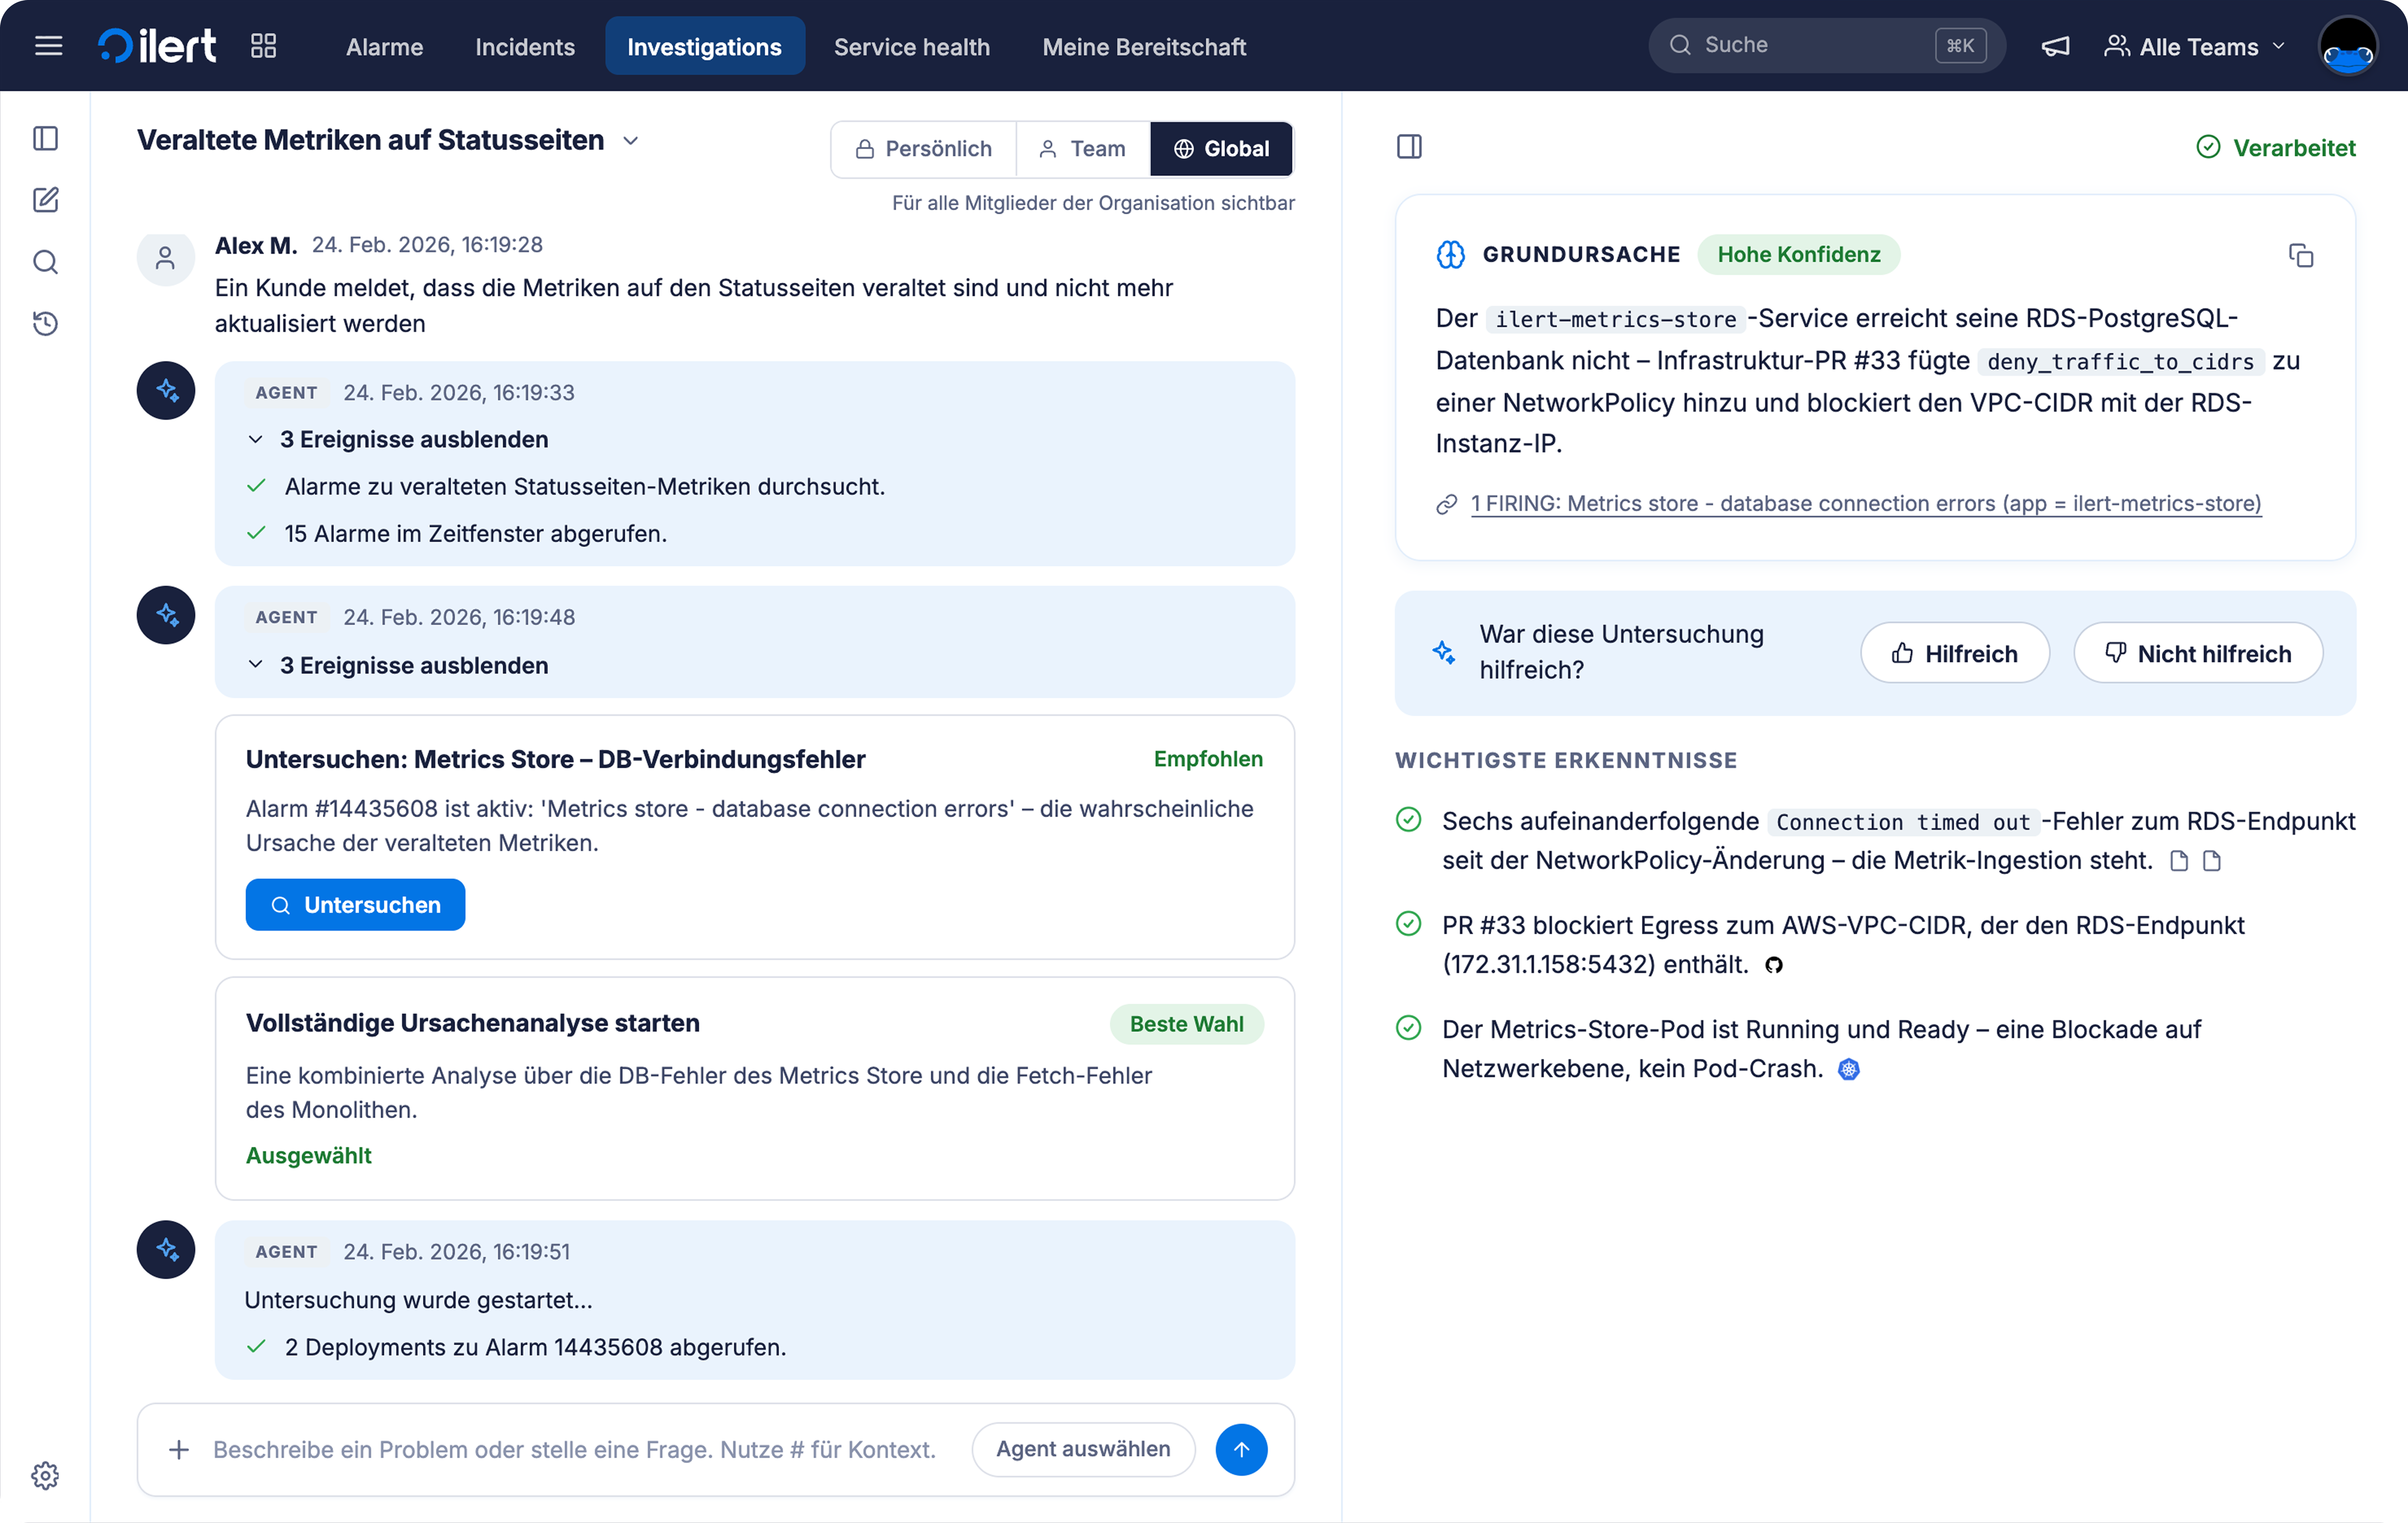
Jede Analyse folgt demselben Muster. Zunächst formuliert der AI SRE eine Hypothese zur Root Cause und versieht sie mit einem Konfidenzniveau: hoch, mittel oder niedrig. Dazu kommen fünf oder sechs zentrale Erkenntnisse. Jede davon ist direkt mit dem jeweiligen Beleg verknüpft: dem betreffenden Deployment, der Log-Zeile mit dem Out-of-Memory-Fehler oder der Metrik, die als erste auffällig wurde. Außerdem zeigt der AI SRE in einer kurzen Liste, welche möglichen Ursachen ausgeschlossen wurden.
Wo es sinnvoll ist, schlägt er zudem eine konkrete Maßnahme vor: auf die letzte fehlerfreie Version zurückrollen, den Arbeitsspeicher des betreffenden Pods verdoppeln oder den Service neu starten.
Danach wartet der AI SRE auf Ihre Entscheidung. Sie entscheiden, was passiert. Am Zustand Ihres Systems ändert sich nichts, solange kein Engineer die vorgeschlagene Maßnahme ausdrücklich freigibt.
Aktuell stoßen Sie die Analyse selbst an. Dafür gibt es drei Möglichkeiten: aus einer Alarmierung, aus einem Incident oder indem Sie dem Agenten im Chat beschreiben, was Sie beobachten. Eine Beschreibung in natürlicher Sprache reicht aus. „Kunden berichten, dass die Metriken auf ihren Statusseiten nicht aktuell sind“ ist bereits eine vollständige Problembeschreibung – und genau so wurde auch der Incident im nächsten Abschnitt an den Agenten übergeben.
Analysen, die automatisch starten, sobald eine Alarmierung ausgelöst wird, sodass das Ergebnis bereits vorliegt, wenn Sie zum Telefon greifen, sind der nächste Schritt – aber noch nicht Bestandteil dieses Releases.
Ein Fall aus der Praxis
Vor einiger Zeit haben wir einen externen Penetrationstest durchführen lassen. Dabei wurde eine Blind-SSRF-Schwachstelle in der Metrikfunktion unserer Statusseiten entdeckt: Kunden können eine Statusseite mit Datadog oder Prometheus verbinden, um API-Antwortzeiten anzuzeigen. Ein Angreifer konnte jedoch versuchen, diesen Fetcher stattdessen interne URLs aufrufen zu lassen.
Wir haben die Schwachstelle noch in derselben Woche mit einer Kubernetes Network Policy behoben. Diese Network Policy war allerdings zu weit gefasst. Dadurch konnte der Metrics Service nicht mehr mit seiner eigenen Datenbank kommunizieren, und die Metriken auf den Statusseiten der Kunden wurden nicht mehr aktualisiert.
Ich halte diesen Incident aus zwei Gründen für einen guten Testfall: Erstens gibt es kein Runbook der Welt, das den Fall „Nach einem Pentest-Fix werden die Metriken auf den Statusseiten nicht mehr aktualisiert“ abdeckt. Für neuartige Incidents gibt es keine Runbooks.
Zweitens ist das Symptom nicht eindeutig: Wenn Sie einem Agenten sagen „Kunden berichten, dass die Metriken nicht mehr funktionieren“, gibt es intern ein Dutzend Dinge, die „Metrics“ heißen und denen er nachgehen könnte – einschließlich unseres gesamten Prometheus-Setups.
Der Agent musste zunächst mögliche Pods identifizieren, dann die Logs finden, die zeigten, dass ein Service seine Datenbank nicht erreichen konnte, und anschließend die jüngsten Änderungen zurückverfolgen, bis er schließlich bei der Network Policy landete. Genau diese Art von Suche kostet einen Menschen nachts schnell eine Stunde – und genau in dieser Art von Suche ist der Agent besonders gut.
Warum es zum Start der allgemeinen Verfügbarkeit keinen autonomen Modus gibt
Wir denken bei Autonomie in verschiedenen Stufen. Nur beobachten: Der Agent hat ausschließlich Lesezugriff und erstellt eine Analyse. Vorschlagen: Der Agent empfiehlt eine Maßnahme, die von einem Menschen freigegeben wird. Vorab genehmigte Maßnahmen: Bestimmte risikoarme Maßnahmen darf der Agent selbstständig ausführen, wenn seine Konfidenz hoch ist. Vollständig autonom: Sie werden nur noch alarmiert, wenn der Agent nicht weiterkommt.
Zum aktuellen Zeitpunkt sind die ersten beiden Stufen verfügbar und ich möchte klar sagen, warum: Der Nutzen eines Agenten wächst mit dem Grad seiner Autonomie. Ein selbstfahrendes Auto, bei dem Sie die Straße weiterhin im Blick behalten müssen, ist hilfreich. Eines, bei dem das nicht mehr nötig ist, ist ein ganz anderes Produkt.
Ich bin überzeugt, dass wir diesen Punkt erreichen werden. Und ich glaube, dass Agenten für den Produktiveinsatz einen ähnlichen Reifegrad erreichen werden, wie ihn Coding Agents im vergangenen Jahr erreicht haben. Aber aktuell sehe ich keine Möglichkeit, vollständige Autonomie sicher umzusetzen. Deshalb würde ich sie heute selbst nicht einsetzen – und ich denke auch nicht, dass Sie das tun sollten.
In Demos zeigen wir, wie der Agent den gesamten Prozess Ende-zu-Ende übernimmt: von der Analyse über die Aktualisierung der Statusseite bis hin zur Behebung. Und wir sagen jedes Mal dazu: Bitte nicht zu Hause nachmachen.
Beobachten und Vorschlagen ist keineswegs nur eine Notlösung. Durch den reinen Lesezugriff bleibt selbst dann, wenn der Agent völlig danebenliegt, der mögliche Schaden auf eine fehlerhafte Analyse beschränkt. Und der größte Teil der Zeit bei einem Incident entfällt ohnehin auf die Root-Cause-Analyse. Wenn sich diese von 45 Minuten auf wenige Minuten verkürzen lässt, ist damit bereits der größte Teil des Nutzens realisiert – noch bevor der Agent überhaupt Änderungen am System vornimmt.
Was der Agent liest – und was ganz bewusst nicht
Die beste Dokumentation dafür, wie ein System tatsächlich funktioniert, sind der Code und die Live-Telemetrie. Alles andere veraltet. Deshalb beginnt der AI SRE seine Analyse nicht mit Ihrem Confluence, Ihrem Notion oder Ihren Runbooks. Einen Agenten auf ein Wiki mit Hunderten von Runbooks anzusetzen, von denen das jüngste vor drei Jahren aktualisiert wurde, richtet mehr Schaden an, als dass es brauchbare Ergebnisse liefert.
Was der AI SRE hingegen liest, sind alle Daten, die Sie bereits an ilert senden, sowie die zusätzlich angebundenen Quellen: Logs aus Elastic oder CloudWatch, Dashboards und Metriken aus Grafana, Prometheus oder InfluxDB, Ihr Kubernetes-Cluster, Ihre GitHub-Repositories und Ihre CI/CD-Pipeline. Genau auf diese Breite kommt es an.
Jeder Observability-Anbieter entwickelt derzeit einen eigenen AI SRE – und jeder sieht nur seinen eigenen Ausschnitt. Wir bilden eine übergreifende Ebene über all diesen Systemen, bleiben anbieterneutral und beziehen auch eine Root-Cause-Analyse Ihres Observability-Tools einfach als eine von vielen Informationsquellen ein. Niemand braucht ein weiteres isoliertes Tool, das eine Root-Cause-Analyse nur für eine einzige Datenquelle durchführen kann.
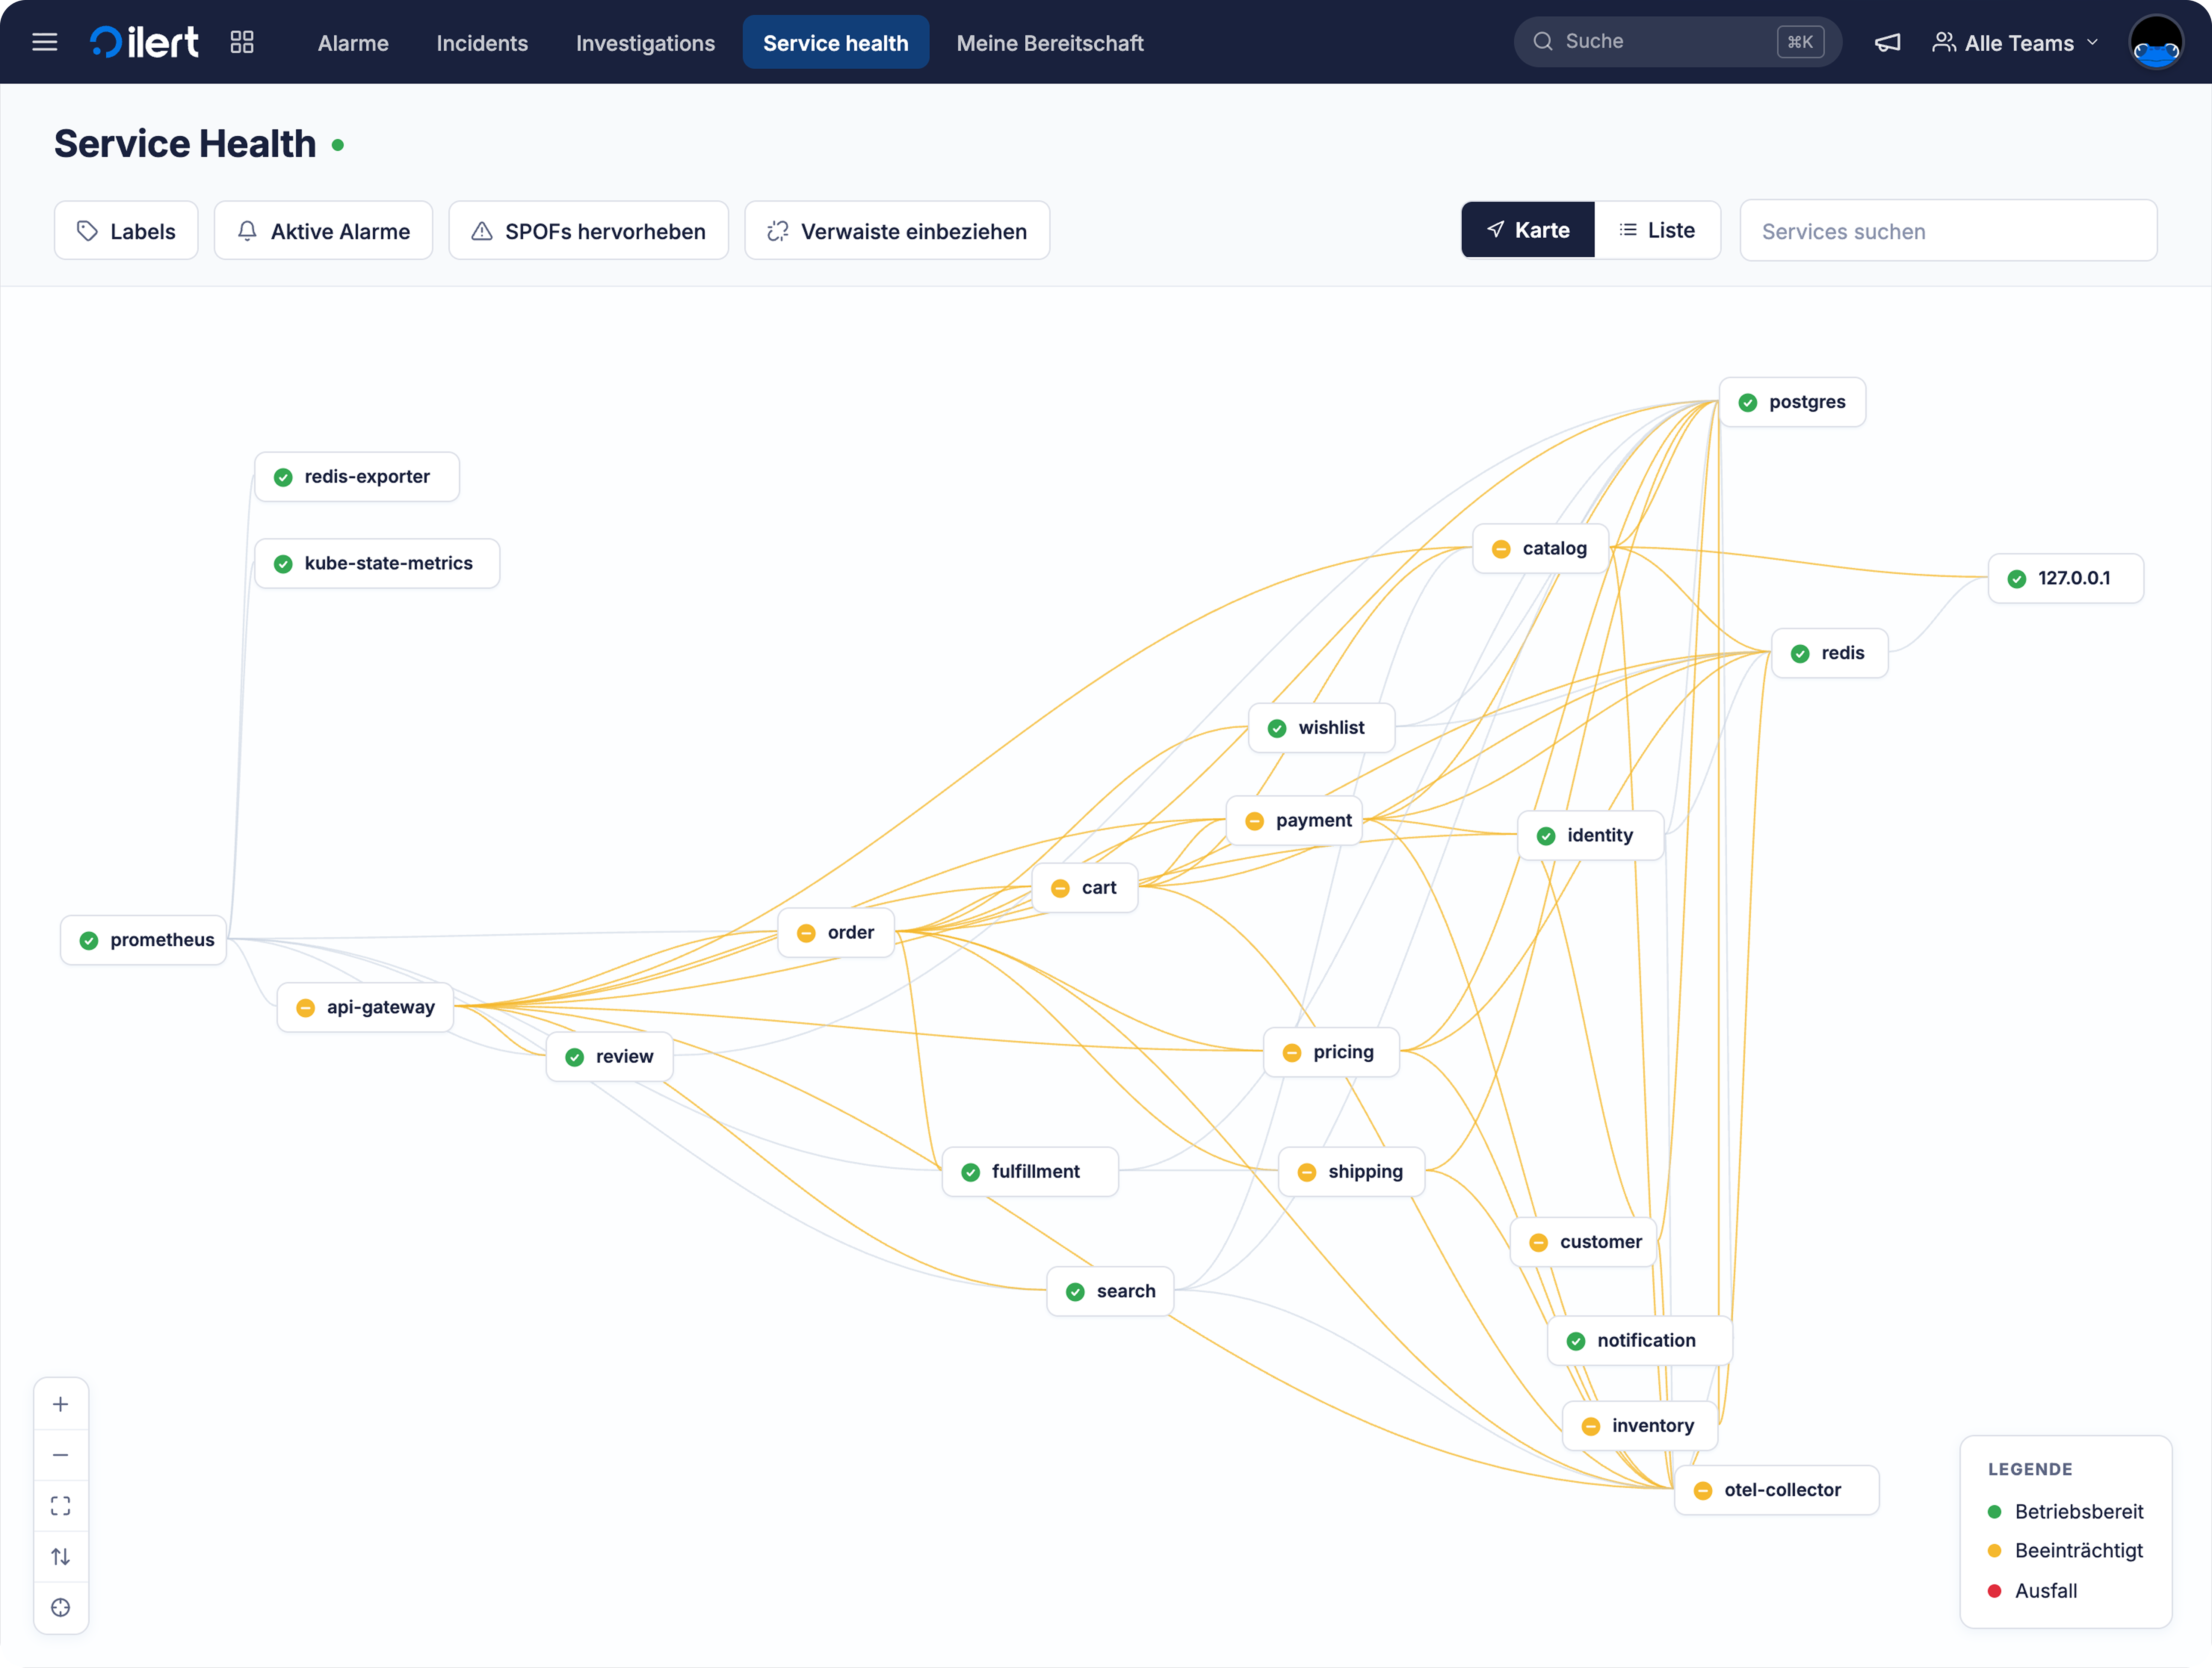
Zusätzlich zu den von Ihnen angebundenen Quellen führt der Agent bei der Einrichtung eine Discovery-Phase durch – und erneut, wenn er längere Zeit inaktiv war. Dabei erstellt er aus Live-Tracing-Daten eine Service-Topologie und versteht so die Abhängigkeiten in Ihrem System, ohne dass jemand einen Servicekatalog manuell pflegen muss.
Diese Topologie ermöglicht es dem Agenten außerdem, Alarmierungen zunächst kosteneffizient zu triagieren, bevor er eine tiefergehende Analyse mit leistungsfähigeren – aber auch teureren – Reasoning-Modellen startet.
Wenn Sie kein Tracing instrumentiert haben – und das ist bei den meisten Unternehmen der Fall –, können Sie einen eBPF-Collector in Ihrem Cluster bereitstellen und damit einen Großteil der nötigen Transparenz gewinnen, ohne dafür in den Code eingreifen zu müssen.
Mit der Zeit baut der Agent ein schlankes Langzeitgedächtnis für das implizite Wissen auf, das er sich aneignet – etwa Dinge wie: „Dieser Service stößt um Mitternacht immer an seine Grenzen, weil dann die Batch-Jobs laufen.“ Dieses Wissen wird als einfacher Text gespeichert. Es gibt keine Vektordatenbank, die synchron gehalten werden muss.
So testen wir den Agent
Für Root-Cause-Analysen gibt es keine feste Vorgehensweise – und genau das macht sie schwer zu testen. Deshalb setzen wir auf drei Ansätze.
Erstens: ein öffentlicher Benchmark. OpenRCA von Microsoft Research ist der anspruchsvollste öffentlich verfügbare Test für Root-Cause-Analysen, den ich kenne: 335 reale Fehlerfälle aus drei Produktivsystemen, 68 GB Telemetriedaten und eine Alles-oder-nichts-Bewertung pro Aufgabe. Was für einen vollen Punkt erforderlich ist, hängt von der jeweiligen Aufgabe ab: Bei manchen müssen die richtige Komponente, die Ursache und der Zeitpunkt identifiziert werden, andere werden anhand einer kleineren Teilmenge bewertet – teilweise reicht bereits die richtige Komponente.
Zum Zeitpunkt der Veröffentlichung des Papers löste die beste veröffentlichte Baseline – ein Agent auf Basis von Claude 3.5 Sonnet – rund 11 % der Fälle. Als wir unseren eigenen Benchmark durchführten, hatte sich der Stand auf dem Leaderboard bereits weiterentwickelt: Opus 4.6 lag bei ungefähr 36 %. Die 11 % sollten daher als Wert aus dem ursprünglichen Paper verstanden werden und nicht als heutiger Stand der Technik.
Bei einer Stichprobe von 50 Aufgaben aus allen drei Systemen löste unser erster Prototyp nach den strengen Bewertungskriterien 26 % der Fälle. Legt man die weiter gefasste Bewertung zugrunde, stimmte das Ergebnis in 30 % der Fälle mit der Ground Truth überein. Eine Analyse dauerte dabei im Schnitt rund neun Minuten.
Ich würde die 26 % eher als Untergrenze betrachten – und angesichts der kleinen Stichprobe entsprechend vorsichtig interpretieren. Wichtiger als die eigentliche Zahl sind jedoch zwei Erkenntnisse aus dem Test: Als wir dem Agenten direkten Zugriff auf die Rohdaten der Telemetrie über eine einfache Shell gaben, statt ihn mit unseren acht produktionsnahen Grafana- und Prometheus-Tools arbeiten zu lassen, stieg die Erfolgsquote nach den strengen Kriterien von 14 % auf 26 % – und das bei weniger Tool-Aufrufen. Mit anderen Worten: Wie die Tools gestaltet sind, ist alles andere als nebensächlich.
Hinzu kommt: OpenRCA arbeitet ausschließlich mit Telemetriedaten. Informationen zu Deployments, Konfigurationsänderungen oder Alarmierungen stehen dem Agenten dort nicht zur Verfügung. Im Produktiveinsatz gehören gerade Änderungen jedoch zu seinen wichtigsten Hinweisen auf die Ursache eines Incidents. Der Benchmark testet den Agenten also gewissermaßen mit angezogener Handbremse.
Im selben Durchlauf erreichte Claude Code mit unserem Investigator Prompt 38 % und schnitt damit besser ab als unser eigener Harness. Auch dieses Ergebnis veröffentlichen wir bewusst, denn genau daran messen wir uns intern: Wenn ein allgemeiner Coding Agent mit Ihrem Prompt besser abschneidet als der eigens dafür entwickelte Harness, dann muss der Harness noch besser werden.
Zweitens: Chaos-Tests. Wir erzeugen gezielt echte Fehler in einer realen Umgebung und geben dem Agenten nur das, was auch ein Engineer im Bereitschaftsdienst sehen würde: die Symptome. Der Agent erfährt nie, was wir absichtlich kaputtgemacht haben.
In rund einem Dutzend Szenarien – darunter fehlerhafte Deployments, fehlerhafte Konfigurationsänderungen, Ressourcenengpässe und Ausfälle von Abhängigkeiten – zeigte sich:
In allen Testläufen wurde die richtige Root Cause identifiziert.
Die mittlere Zeit von der Alarmierung bis zur ersten Erkenntnis lag bei 194 Sekunden.
In 90 % der Testläufe entsprach die vorgeschlagene Behebungsmaßnahme dem Vorgehen unserer Engineers.
Falsche Hypothese mit hoher Konfidenz: null. Genau diesen Wert beobachten wir am genauesten.
Drittens: Replay-Tests. Jede Analyse aus dem Produktivbetrieb wird aufgezeichnet: jeder Tool-Aufruf, jede Antwort und die abschließende Root-Cause-Analyse. Wenn wir ein Modell oder einen Prompt ändern, spielen wir diese Aufzeichnungen erneut durch und vergleichen die Ergebnisse – sowohl mithilfe eines LLM als Bewertungsinstanz als auch anhand der Ähnlichkeit der Embeddings. So erkennen wir Regressionen, wenn ein neues Modell veröffentlicht wird. Allerdings erfasst dieses Verfahren nicht alles: Eine Aufzeichnung deckt nur die Tools ab, die im ursprünglichen Durchlauf tatsächlich verwendet wurden.
Manchmal liegt der Agent falsch. Nicht im Sinne von Halluzinationen – davon sehen wir in einer stark kontextualisierten Umgebung nur sehr wenig. Sondern schlicht falsch: Er zieht aus den Symptomen mit hoher Sicherheit die falsche Schlussfolgerung über die Ursache. Die Konfidenzbewertung und die Links zu den Belegen sollen Ihnen ermöglichen, das innerhalb von weniger als einer Minute zu erkennen. Dann können Sie den Agenten entweder mit einer Rückfrage in die richtige Richtung lenken oder die Analyse selbst übernehmen.
Was der Agent nicht kann
Der Agent handelt nicht eigenständig. Jede Maßnahme muss freigegeben werden.
Er sieht nur die Systeme und Datenquellen, die Sie anbinden. Der größte Nutzen eines Agenten entsteht durch den Kontext, den er erhält. Wenn er nicht erkennen kann, dass gerade ein Deployment stattgefunden hat, kann er das Deployment auch nicht als Ursache identifizieren.
Fehlende Observability kann er nicht ausgleichen. Manche hoffen, dass sich dieser Schritt mit einem Agenten überspringen lässt. Das funktioniert nicht – zumindest noch nicht.
Auch darin, einen einmal eingeschlagenen falschen Weg selbstständig wieder zu verlassen, ist der Agent noch nicht besonders gut. Wenn der Suchraum groß und der Ausgangspunkt unklar ist, kann er sich festfahren. Dann hilft eine Rückfrage – oder Sie übernehmen die Analyse selbst.
Das ändert sich für Ihr Team
Die Gespräche, die wir heute mit Engineering-Verantwortlichen führen, unterscheiden sich deutlich von den früheren Diskussionen rund um MTTR. Ein Muster begegnet mir dabei immer wieder: Ein kleines, starkes SRE-Team übernimmt den First-Level-Bereitschaftsdienst für viele Produktteams, während der Agent die Triage und die erste Analyse übernimmt.
Faire Bereitschaftsrotationen führen normalerweise dazu, dass jedes Service-Team etwa fünf Personen vorhalten muss, nur um den Bereitschaftsdienst abzudecken. Wird der First-Level-Bereitschaftsdienst bei einem zentralen, durch KI unterstützten Team gebündelt, entfällt diese Vorgabe für die einzelnen Teams. Engineers verbringen mehr Zeit mit der Entwicklung und weniger Zeit in Incident-Konferenzen mit 25 Beteiligten. Gleiche Teamgröße, mehr betreute Services, geringere Kosten pro Incident.
Genau diese Form von „KI im IT-Betrieb“ halte ich für sinnvoll: nicht weniger Engineers, sondern Engineers, die dafür eingestellt wurden, Dinge zu entwickeln, und genau das auch tun können. Niemand wurde eingestellt, um Vollzeit Bereitschaftsdienst zu leisten.
Ihre Daten
Alle KI-Workloads laufen auf dedizierter Infrastruktur in unseren EU-Regionen Frankfurt und Stockholm. Die Modelle werden über regionale Endpoints aufgerufen. Wir trainieren nicht mit Ihren Daten und haben bei allen von uns eingesetzten Modellanbietern der Nutzung zu Trainingszwecken widersprochen.
Für Analysen benötigt der Agent ausschließlich API-Keys mit Lesezugriff. Personenbezogene Daten und Daten auf Nutzerebene werden nicht an externe Modelle weitergegeben. Wenn Ihr Security-Team eigene Modell-API-Keys hinter den unternehmenseigenen Guardrails verwenden möchte, unterstützen wir auch dieses Modell.
Der AI SRE ist ab heute in allen kostenpflichtigen Tarifen sowie während der Testphase verfügbar und nutzt die in Ihrem Tarif enthaltenen AI Credits: 250 pro Monat im Pro-Tarif, 1.000 im Scale-Tarif und 5.000 im Enterprise-Tarif. Sie können Ihr enthaltenes Kontingent einsehen und selbst festlegen, was passieren soll, wenn es aufgebraucht ist.
Für bestehende Kunden ist keine Migration erforderlich. Aktivieren Sie den AI SRE unter Account settings → AI features, erstellen Sie einen Agenten, verbinden Sie ihn mit Ihren Tools und starten Sie beim nächsten Incident Ihre erste Analyse.
Wo geht die Reise hin?
Unser Ziel ist, dass Sie um 3 Uhr nachts gar nicht mehr alarmiert werden. Stattdessen wachen Sie morgens auf und finden einen Bericht vor: Der Agent hat die akuten Auswirkungen eingedämmt, eine Stunde lang überprüft, dass die Symptome nicht wieder aufgetreten sind, und für die eigentliche Behebung liegt bereits ein Pull Request bereit.
So weit sind wir zum Start der allgemeinen Verfügbarkeit noch nicht. Der aktuelle Stand ist: Die Fehlersuche dauert nur noch wenige Minuten statt einer Stunde, lässt sich mit einem Klick starten und die vorgeschlagene Behebung ist nur einen weiteren Klick entfernt.
Das Vertrauen für alles, was darüber hinausgeht, muss sich der Agent Schritt für Schritt mit jeder einzelnen Analyse verdienen. Und genau hier beginnt diese Reise.
Wenn Sie ein Szenario kennen, bei dem Sie vermuten, dass der Agent falsch liegen wird, würde ich sehr gerne davon hören.
Hoppla! Beim Absenden des Formulars ist etwas schief gelaufen.
Unsere Cookie-Richtlinie
Wir verwenden Cookies, um Ihre Erfahrung zu verbessern, den Seitenverkehr zu verbessern und für Marketingzwecke. Erfahren Sie mehr in unserem Datenschutzrichtlinie.