ilert AI SRE is generally available


Wenn Sie um 3 Uhr nachts alarmiert werden, dauert es etwa 30 Sekunden, bis die Benachrichtigung Sie erreicht, und dann noch zwei Minuten, bis Sie vor dem Laptop sitzen und wach genug sind, um sie zu lesen. Was Sie dann sehen, ist meist eine “nackte” Alarmierung: eine Metrik, ein Schwellenwert, ein Link zu einem Dashboard. Dann beginnt das übliche Ritual: Dashboard öffnen, prüfen, was in den letzten Stunden bereitgestellt wurde, die Logs nach dem ersten Fehler durchsuchen und in Slack fragen, ob jemand Änderungen an der Datenbank vorgenommen hat.
Die meiste Zeit entfällt bei einem Incident auf die Suche nach der Ursache. Sobald die Nadel im Heuhaufen gefunden ist, geht die eigentliche Behebung meist schnell – und häufig ist ein Rollback schon ausreichend. Es ist die Suche, die Sie 20, 45 oder manchmal sogar 60 Minuten Ihrer Nacht kostet.
Die Zielvorgabe für den ilert AI SRE war einfach: Wenn Sie Ihren Laptop öffnen, sollte die Fehlersuche bereits abgeschlossen sein. Vor etwa einem Jahr haben wir die geschlossene Beta gestartet – damals noch unter dem Namen ilert Responder – zunächst mit einigen wenigen Teams. Seitdem haben wir den Agenten dreimal neu aufgebaut. Jede dieser Überarbeitungen hat uns neue Erkenntnisse gebracht: wo ein Agent tatsächlich hilft, wie ein gutes technisches Gerüst aussieht und was „produktionsreif“ bedeutet, wenn der Agent gemeinsam mit Ihnen Bereitschaftsdienst hat.
Jetzt ist der ilert AI SRE in allen kostenpflichtigen Tarifen sowie während der Testphase allgemein verfügbar.
Was macht der AI SRE?
Geben Sie dem AI SRE eine Alarmierung aus einer unserer mehr als 150 Integrationen, und er beginnt mit der Analyse – im Grunde so, wie Sie selbst vorgehen würden, nur schneller. Er prüft Logs, Metriken und Traces. Außerdem untersucht er, was sich geändert hat, denn Änderungen sind die häufigste Ursache für Incidents: Deployments, Konfigurationsänderungen, zusammengeführte Pull Requests und – sofern Sie Ihr Repository angebunden haben – sogar den tatsächlichen Diff.
Wenn 50 Alarmierungen gleichzeitig eingehen, führt der AI SRE zunächst eine Triage durch, fasst sie zu Clustern zusammen und untersucht anschließend jedes Cluster separat.
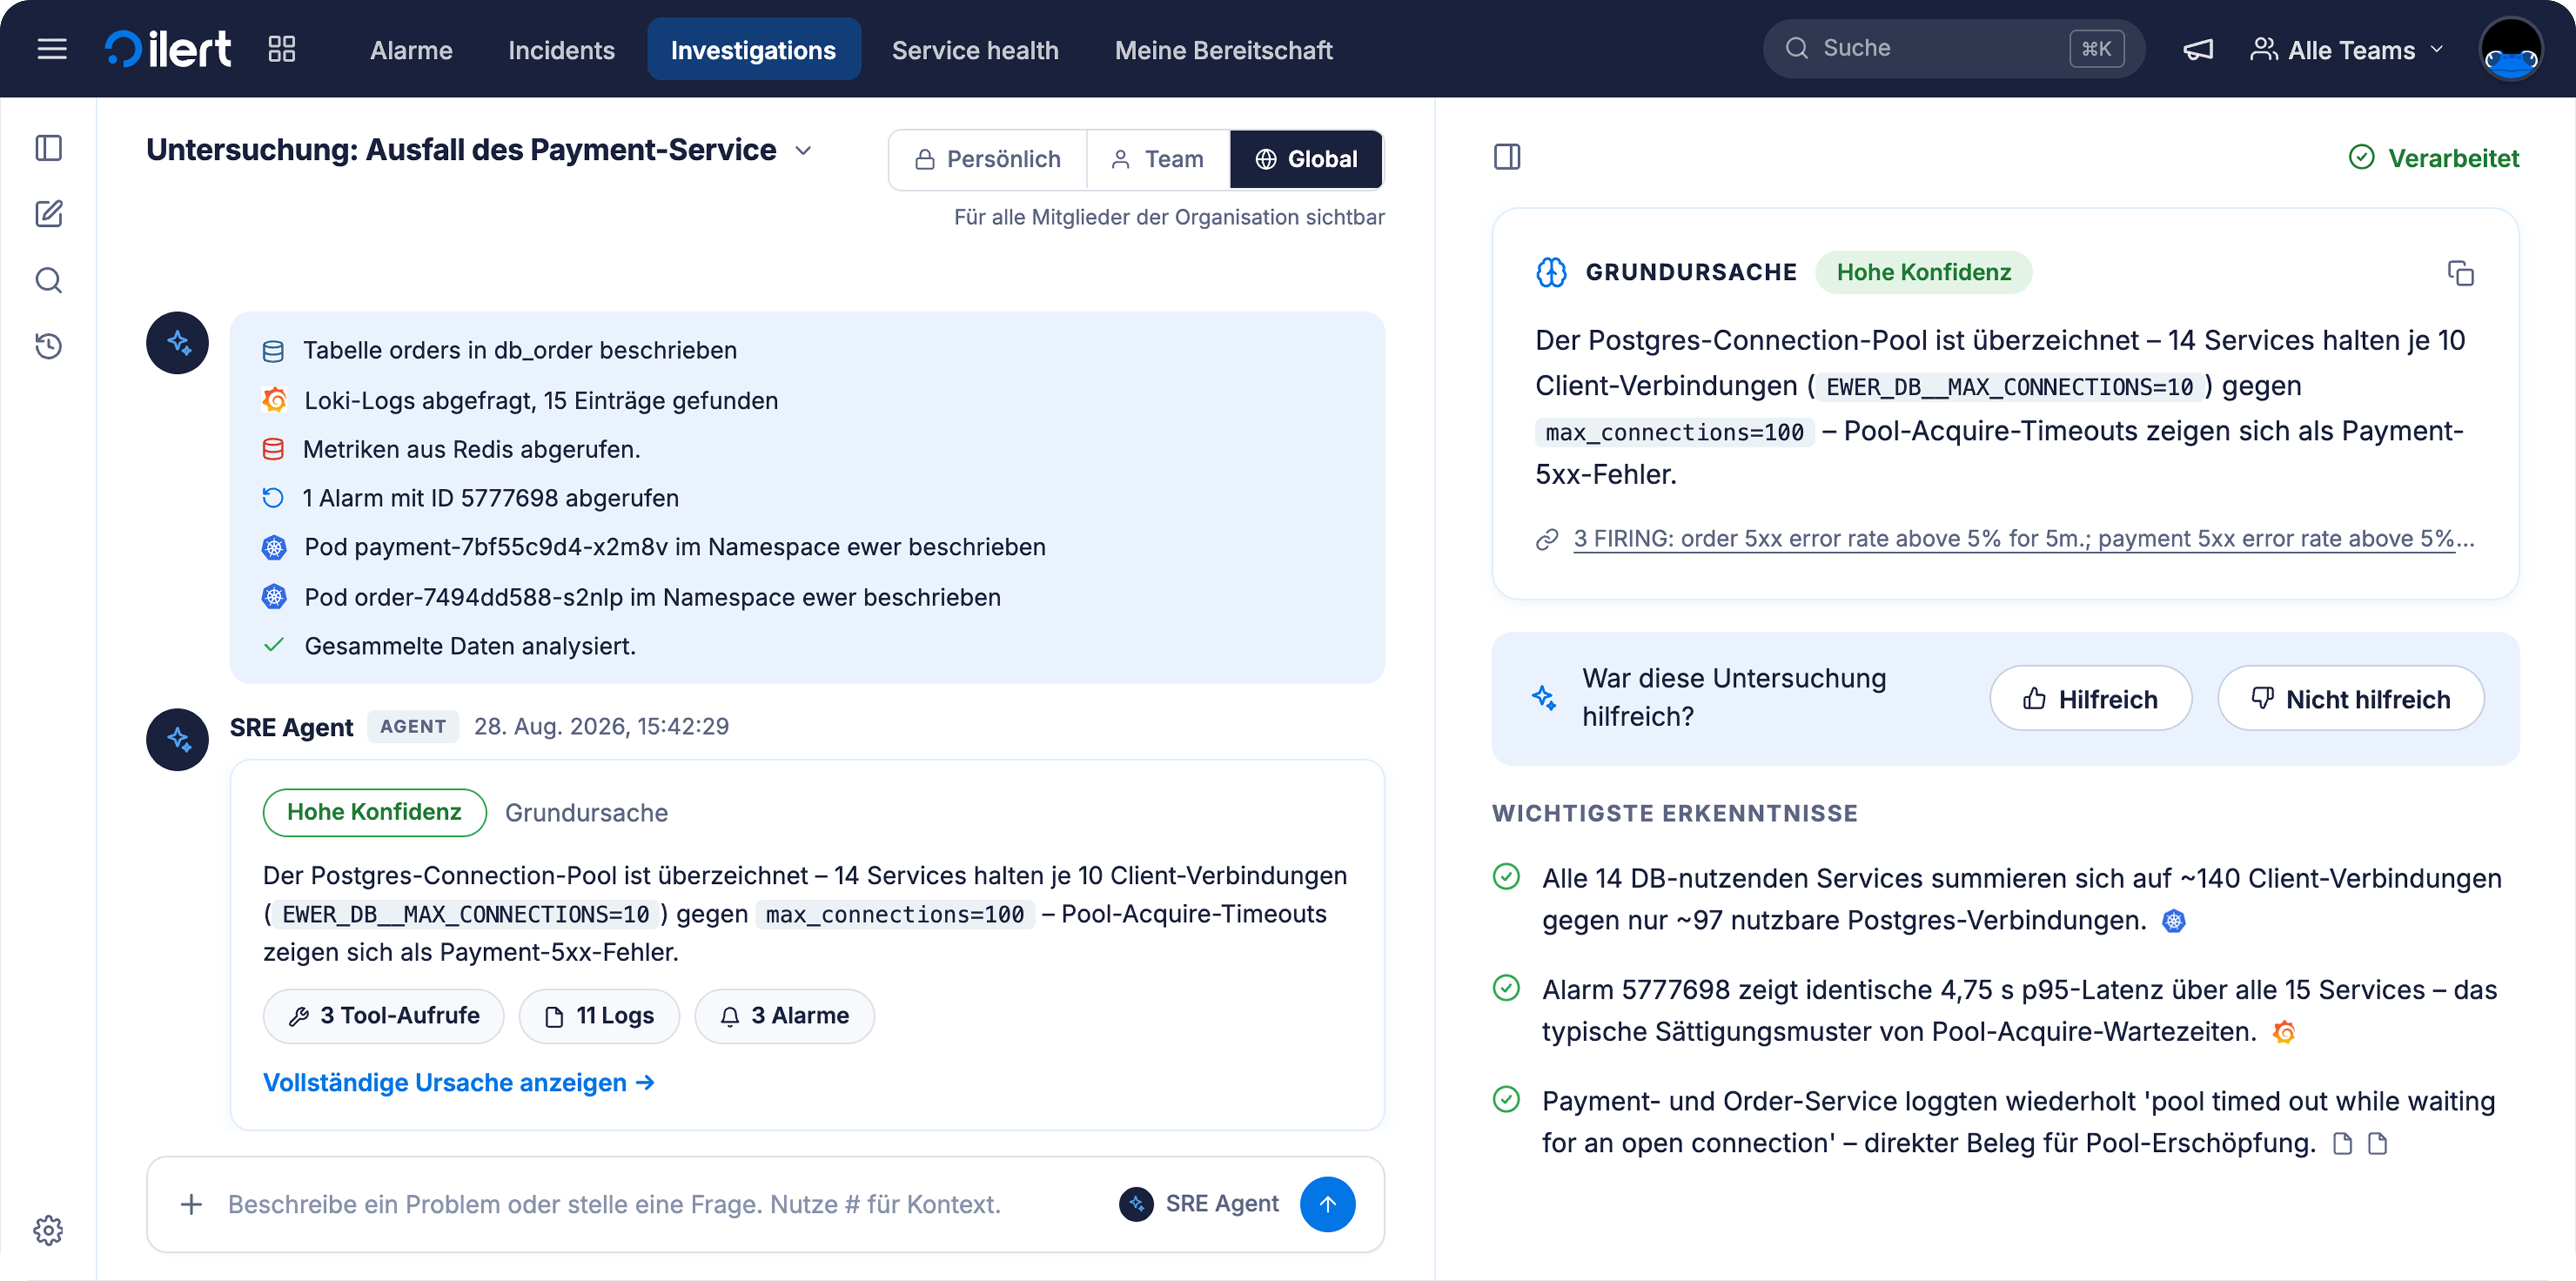
Ein paar Minuten später sehen Sie nicht nur eine reine Alarmierung – stattdessen liegt Ihnen bereits eine Root-Cause-Analyse vor.
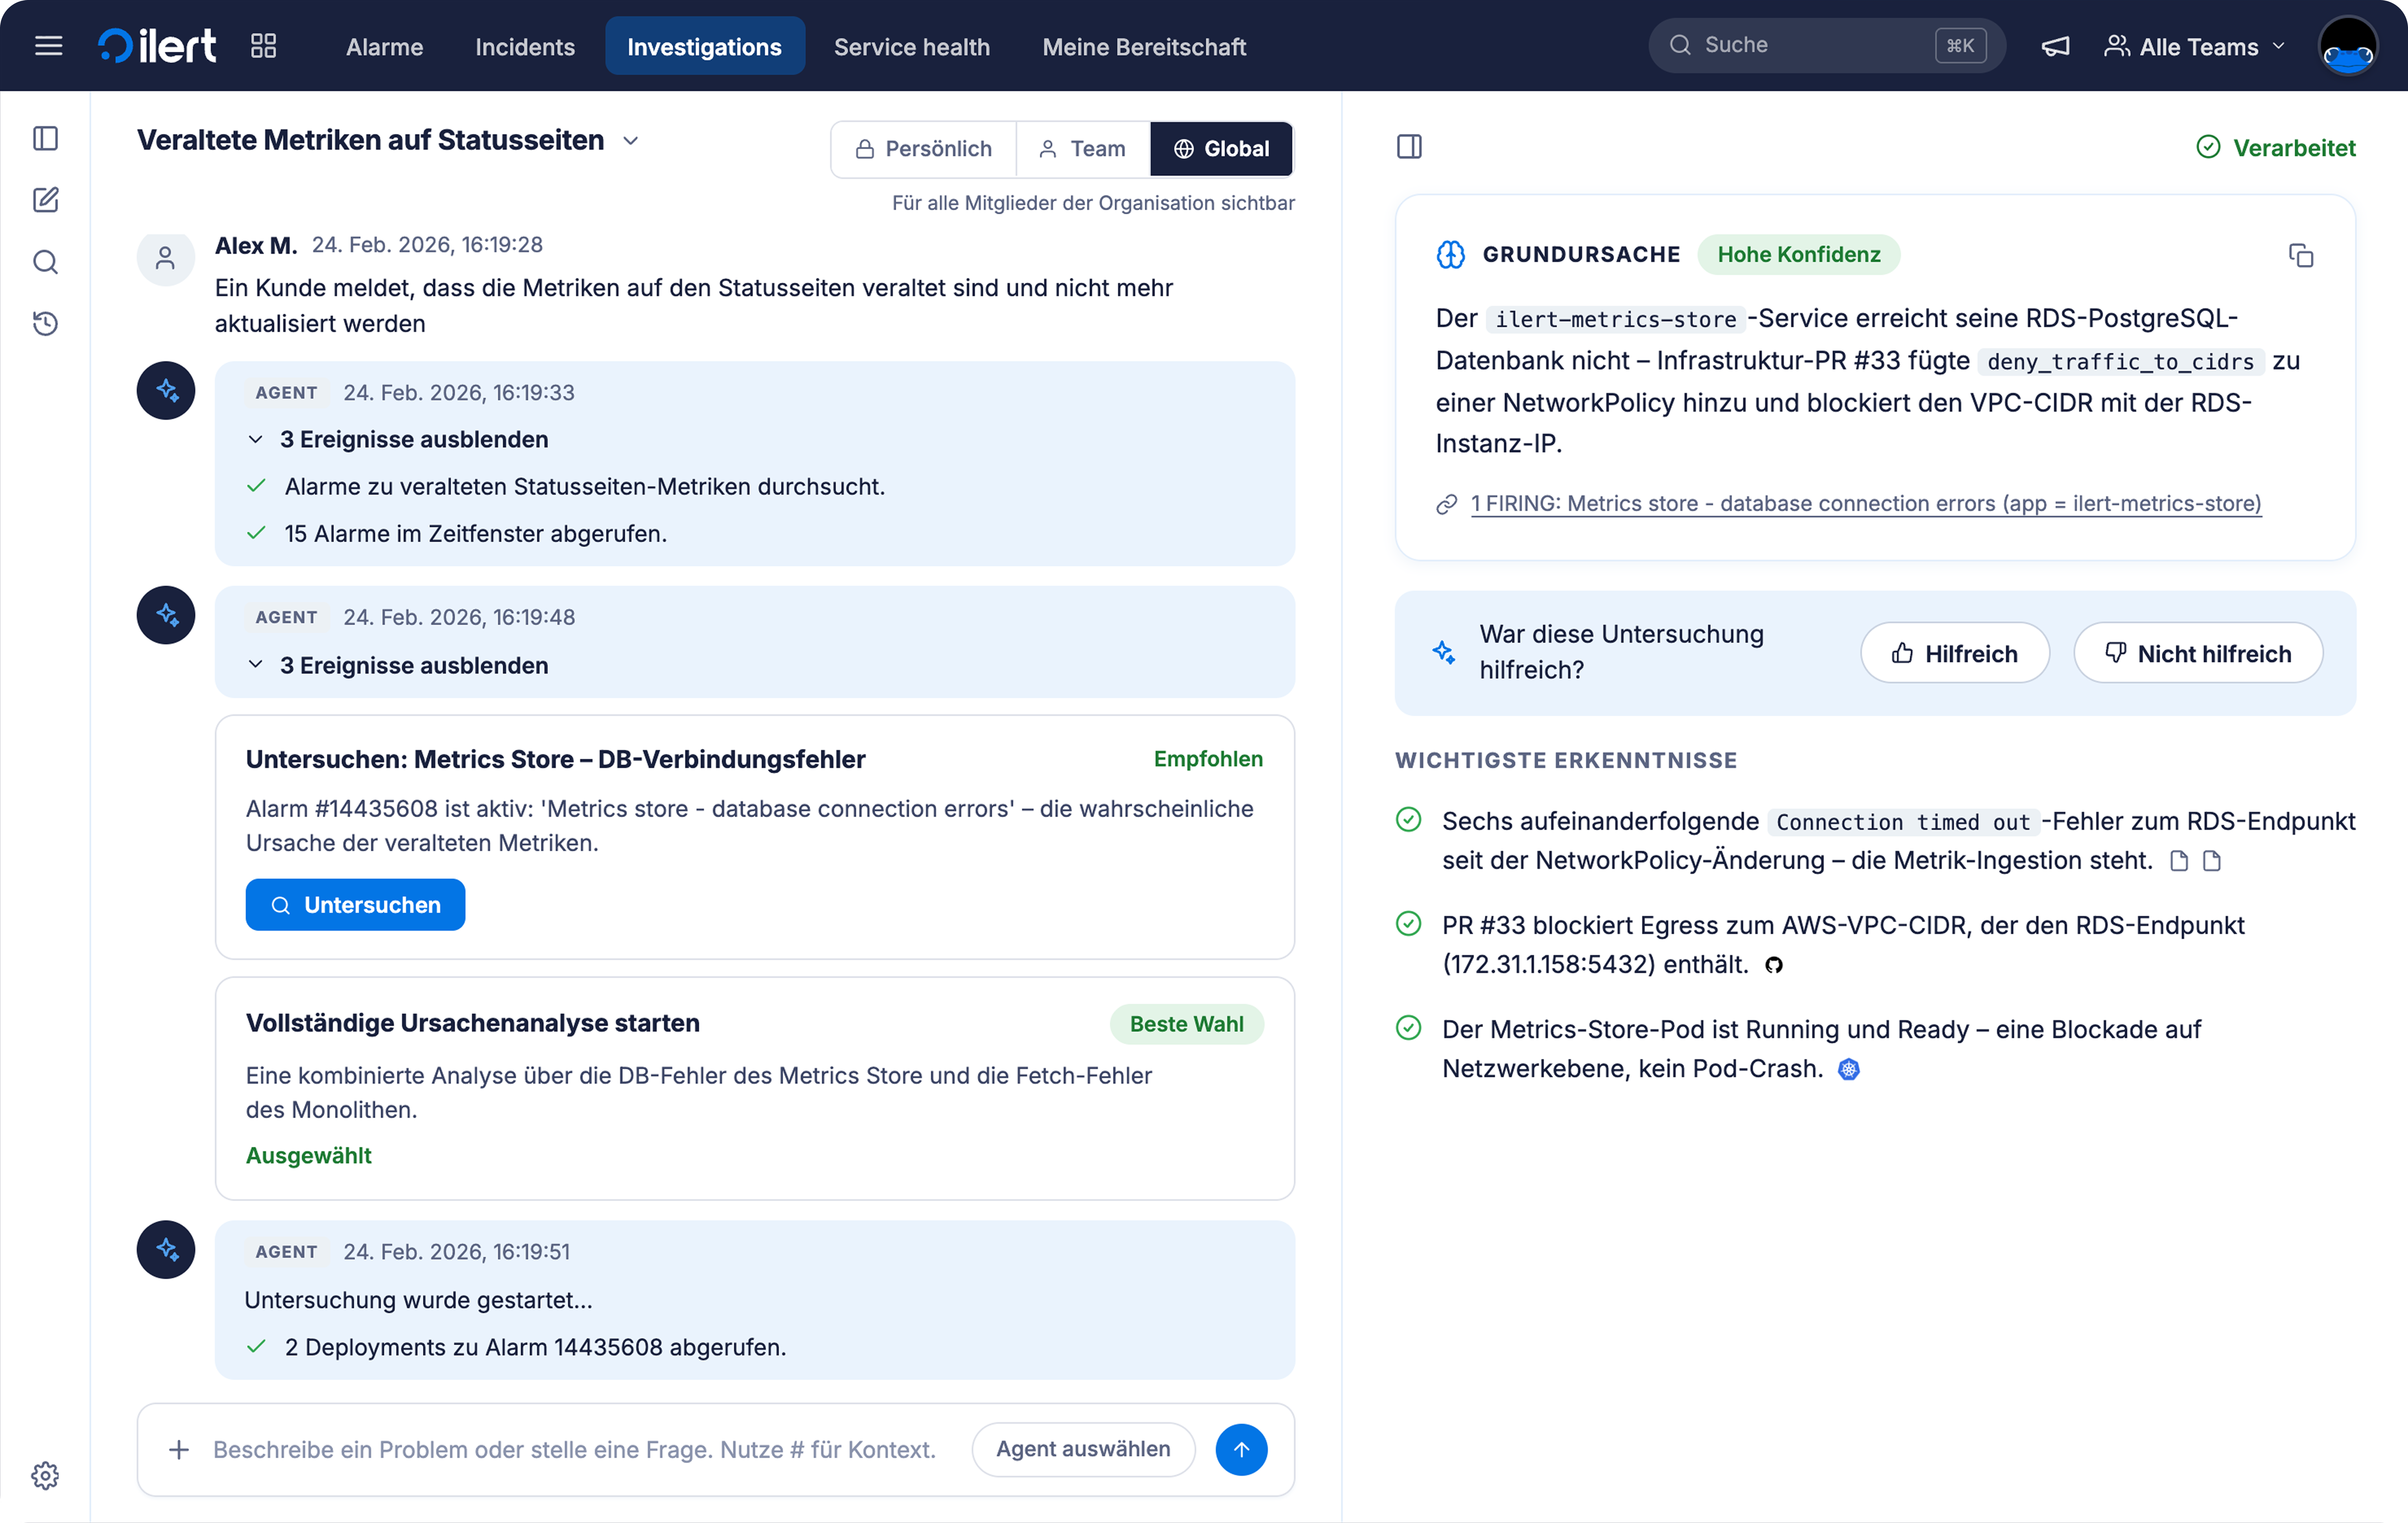
Jede Analyse folgt demselben Muster. Zunächst formuliert der AI SRE eine Hypothese zur Root Cause und versieht sie mit einem Konfidenzniveau: hoch, mittel oder niedrig. Dazu kommen fünf oder sechs zentrale Erkenntnisse. Jede davon ist direkt mit dem jeweiligen Beleg verknüpft: dem betreffenden Deployment, der Log-Zeile mit dem Out-of-Memory-Fehler oder der Metrik, die als erste auffällig wurde. Außerdem zeigt der AI SRE in einer kurzen Liste, welche möglichen Ursachen ausgeschlossen wurden.
Wo es sinnvoll ist, schlägt er zudem eine konkrete Maßnahme vor: auf die letzte fehlerfreie Version zurückrollen, den Arbeitsspeicher des betreffenden Pods verdoppeln oder den Service neu starten.
Danach wartet der AI SRE auf Ihre Entscheidung. Sie entscheiden, was passiert. Am Zustand Ihres Systems ändert sich nichts, solange kein Engineer die vorgeschlagene Maßnahme ausdrücklich freigibt.
Aktuell stoßen Sie die Analyse selbst an. Dafür gibt es drei Möglichkeiten: aus einer Alarmierung, aus einem Incident oder indem Sie dem Agenten im Chat beschreiben, was Sie beobachten. Eine Beschreibung in natürlicher Sprache reicht aus. „Kunden berichten, dass die Metriken auf ihren Statusseiten nicht aktuell sind“ ist bereits eine vollständige Problembeschreibung – und genau so wurde auch der Incident im nächsten Abschnitt an den Agenten übergeben.
Analysen, die automatisch starten, sobald eine Alarmierung ausgelöst wird, sodass das Ergebnis bereits vorliegt, wenn Sie zum Telefon greifen, sind der nächste Schritt – aber noch nicht Bestandteil dieses Releases.
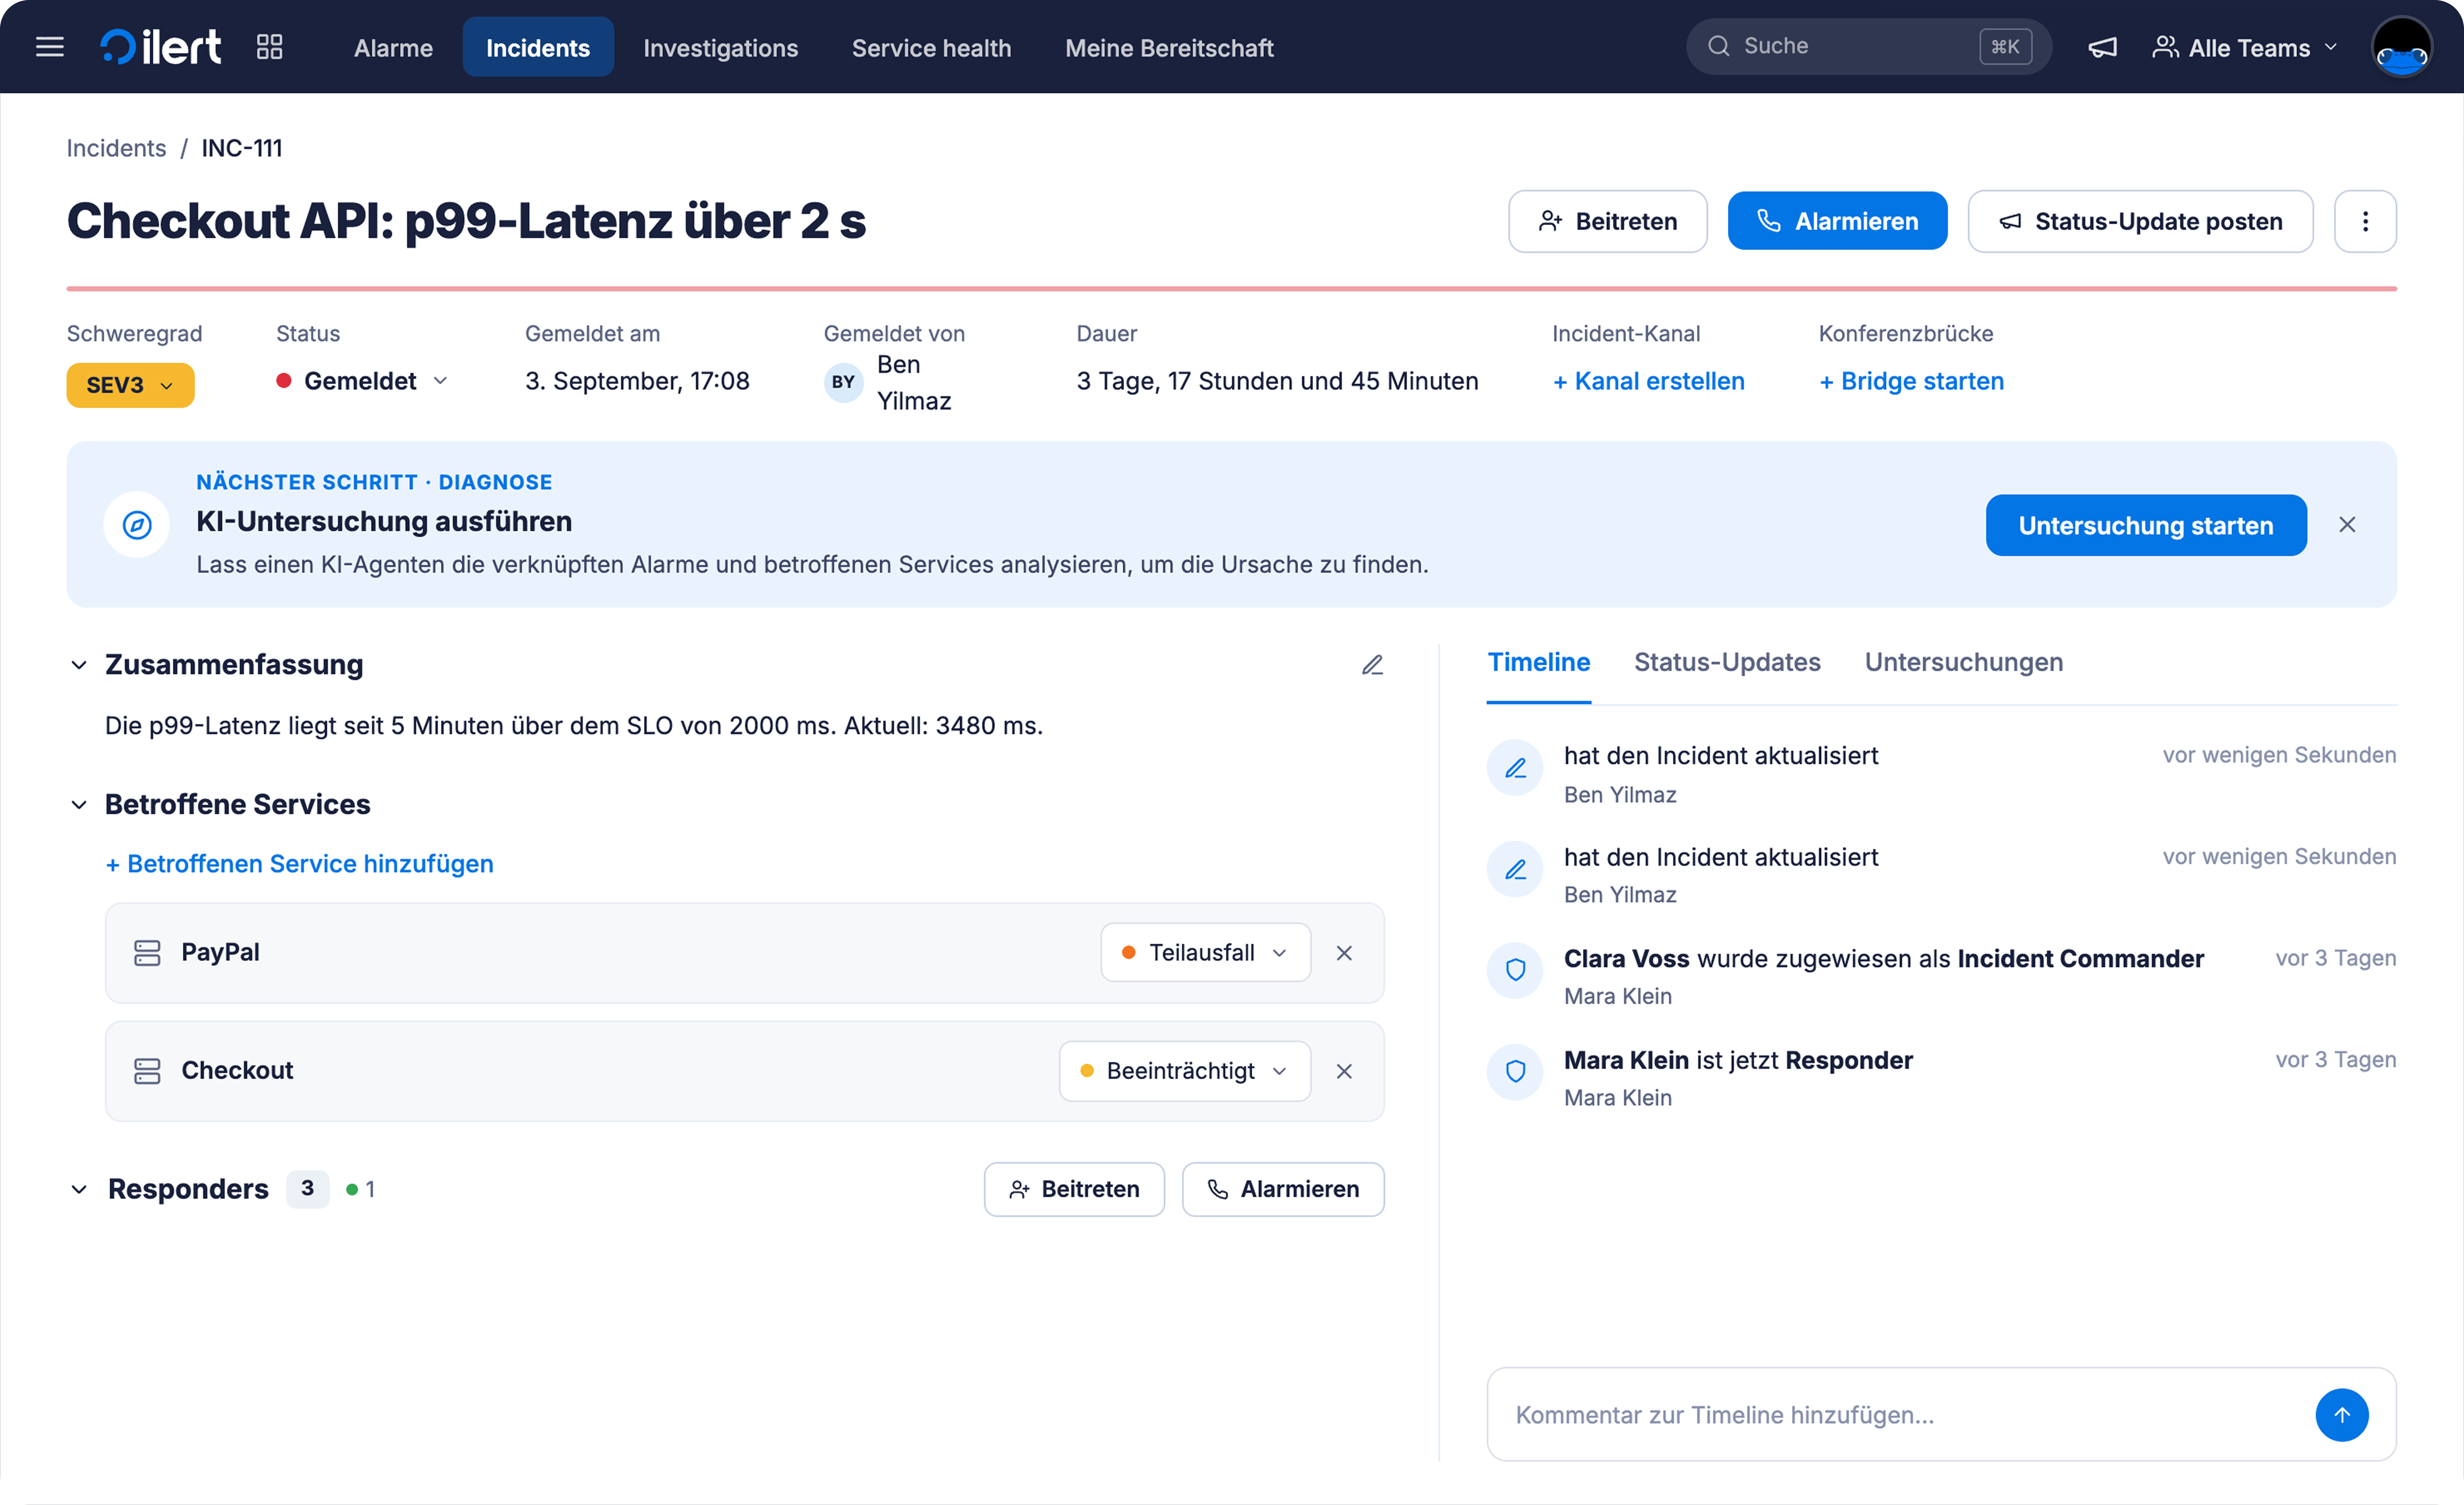
Ein Fall aus der Praxis
Vor einiger Zeit haben wir einen externen Penetrationstest durchführen lassen. Dabei wurde eine Blind-SSRF-Schwachstelle in der Metrikfunktion unserer Statusseiten entdeckt: Kunden können eine Statusseite mit Datadog oder Prometheus verbinden, um API-Antwortzeiten anzuzeigen. Ein Angreifer konnte jedoch versuchen, diesen Fetcher stattdessen interne URLs aufrufen zu lassen.
Wir haben die Schwachstelle noch in derselben Woche mit einer Kubernetes Network Policy behoben. Diese Network Policy war allerdings zu weit gefasst. Dadurch konnte der Metrics Service nicht mehr mit seiner eigenen Datenbank kommunizieren, und die Metriken auf den Statusseiten der Kunden wurden nicht mehr aktualisiert.
Ich halte diesen Incident aus zwei Gründen für einen guten Testfall: Erstens gibt es kein Runbook der Welt, das den Fall „Nach einem Pentest-Fix werden die Metriken auf den Statusseiten nicht mehr aktualisiert“ abdeckt. Für neuartige Incidents gibt es keine Runbooks.
Zweitens ist das Symptom nicht eindeutig: Wenn Sie einem Agenten sagen „Kunden berichten, dass die Metriken nicht mehr funktionieren“, gibt es intern ein Dutzend Dinge, die „Metrics“ heißen und denen er nachgehen könnte – einschließlich unseres gesamten Prometheus-Setups.
Der Agent musste zunächst mögliche Pods identifizieren, dann die Logs finden, die zeigten, dass ein Service seine Datenbank nicht erreichen konnte, und anschließend die jüngsten Änderungen zurückverfolgen, bis er schließlich bei der Network Policy landete. Genau diese Art von Suche kostet einen Menschen nachts schnell eine Stunde – und genau in dieser Art von Suche ist der Agent besonders gut.
Warum es zum Start der allgemeinen Verfügbarkeit keinen autonomen Modus gibt
Wir denken bei Autonomie in verschiedenen Stufen. Nur beobachten: Der Agent hat ausschließlich Lesezugriff und erstellt eine Analyse. Vorschlagen: Der Agent empfiehlt eine Maßnahme, die von einem Menschen freigegeben wird. Vorab genehmigte Maßnahmen: Bestimmte risikoarme Maßnahmen darf der Agent selbstständig ausführen, wenn seine Konfidenz hoch ist. Vollständig autonom: Sie werden nur noch alarmiert, wenn der Agent nicht weiterkommt.
Zum aktuellen Zeitpunkt sind die ersten beiden Stufen verfügbar und ich möchte klar sagen, warum: Der Nutzen eines Agenten wächst mit dem Grad seiner Autonomie. Ein selbstfahrendes Auto, bei dem Sie die Straße weiterhin im Blick behalten müssen, ist hilfreich. Eines, bei dem das nicht mehr nötig ist, ist ein ganz anderes Produkt.
Ich bin überzeugt, dass wir diesen Punkt erreichen werden. Und ich glaube, dass Agenten für den Produktiveinsatz einen ähnlichen Reifegrad erreichen werden, wie ihn Coding Agents im vergangenen Jahr erreicht haben. Aber aktuell sehe ich keine Möglichkeit, vollständige Autonomie sicher umzusetzen. Deshalb würde ich sie heute selbst nicht einsetzen – und ich denke auch nicht, dass Sie das tun sollten.
In Demos zeigen wir, wie der Agent den gesamten Prozess Ende-zu-Ende übernimmt: von der Analyse über die Aktualisierung der Statusseite bis hin zur Behebung. Und wir sagen jedes Mal dazu: Bitte nicht zu Hause nachmachen.
Beobachten und Vorschlagen ist keineswegs nur eine Notlösung. Durch den reinen Lesezugriff bleibt selbst dann, wenn der Agent völlig danebenliegt, der mögliche Schaden auf eine fehlerhafte Analyse beschränkt. Und der größte Teil der Zeit bei einem Incident entfällt ohnehin auf die Root-Cause-Analyse. Wenn sich diese von 45 Minuten auf wenige Minuten verkürzen lässt, ist damit bereits der größte Teil des Nutzens realisiert – noch bevor der Agent überhaupt Änderungen am System vornimmt.
Was der Agent liest – und was ganz bewusst nicht
Die beste Dokumentation dafür, wie ein System tatsächlich funktioniert, sind der Code und die Live-Telemetrie. Alles andere veraltet. Deshalb beginnt der AI SRE seine Analyse nicht mit Ihrem Confluence, Ihrem Notion oder Ihren Runbooks. Einen Agenten auf ein Wiki mit Hunderten von Runbooks anzusetzen, von denen das jüngste vor drei Jahren aktualisiert wurde, richtet mehr Schaden an, als dass es brauchbare Ergebnisse liefert.
Was der AI SRE hingegen liest, sind alle Daten, die Sie bereits an ilert senden, sowie die zusätzlich angebundenen Quellen: Logs aus Elastic oder CloudWatch, Dashboards und Metriken aus Grafana, Prometheus oder InfluxDB, Ihr Kubernetes-Cluster, Ihre GitHub-Repositories und Ihre CI/CD-Pipeline. Genau auf diese Breite kommt es an.
Jeder Observability-Anbieter entwickelt derzeit einen eigenen AI SRE – und jeder sieht nur seinen eigenen Ausschnitt. Wir bilden eine übergreifende Ebene über all diesen Systemen, bleiben anbieterneutral und beziehen auch eine Root-Cause-Analyse Ihres Observability-Tools einfach als eine von vielen Informationsquellen ein. Niemand braucht ein weiteres isoliertes Tool, das eine Root-Cause-Analyse nur für eine einzige Datenquelle durchführen kann.
Zusätzlich zu den von Ihnen angebundenen Quellen führt der Agent bei der Einrichtung eine Discovery-Phase durch – und erneut, wenn er längere Zeit inaktiv war. Dabei erstellt er aus Live-Tracing-Daten eine Service-Topologie und versteht so die Abhängigkeiten in Ihrem System, ohne dass jemand einen Servicekatalog manuell pflegen muss.
Diese Topologie ermöglicht es dem Agenten außerdem, Alarmierungen zunächst kosteneffizient zu triagieren, bevor er eine tiefergehende Analyse mit leistungsfähigeren – aber auch teureren – Reasoning-Modellen startet.
Wenn Sie kein Tracing instrumentiert haben – und das ist bei den meisten Unternehmen der Fall –, können Sie einen eBPF-Collector in Ihrem Cluster bereitstellen und damit einen Großteil der nötigen Transparenz gewinnen, ohne dafür in den Code eingreifen zu müssen.
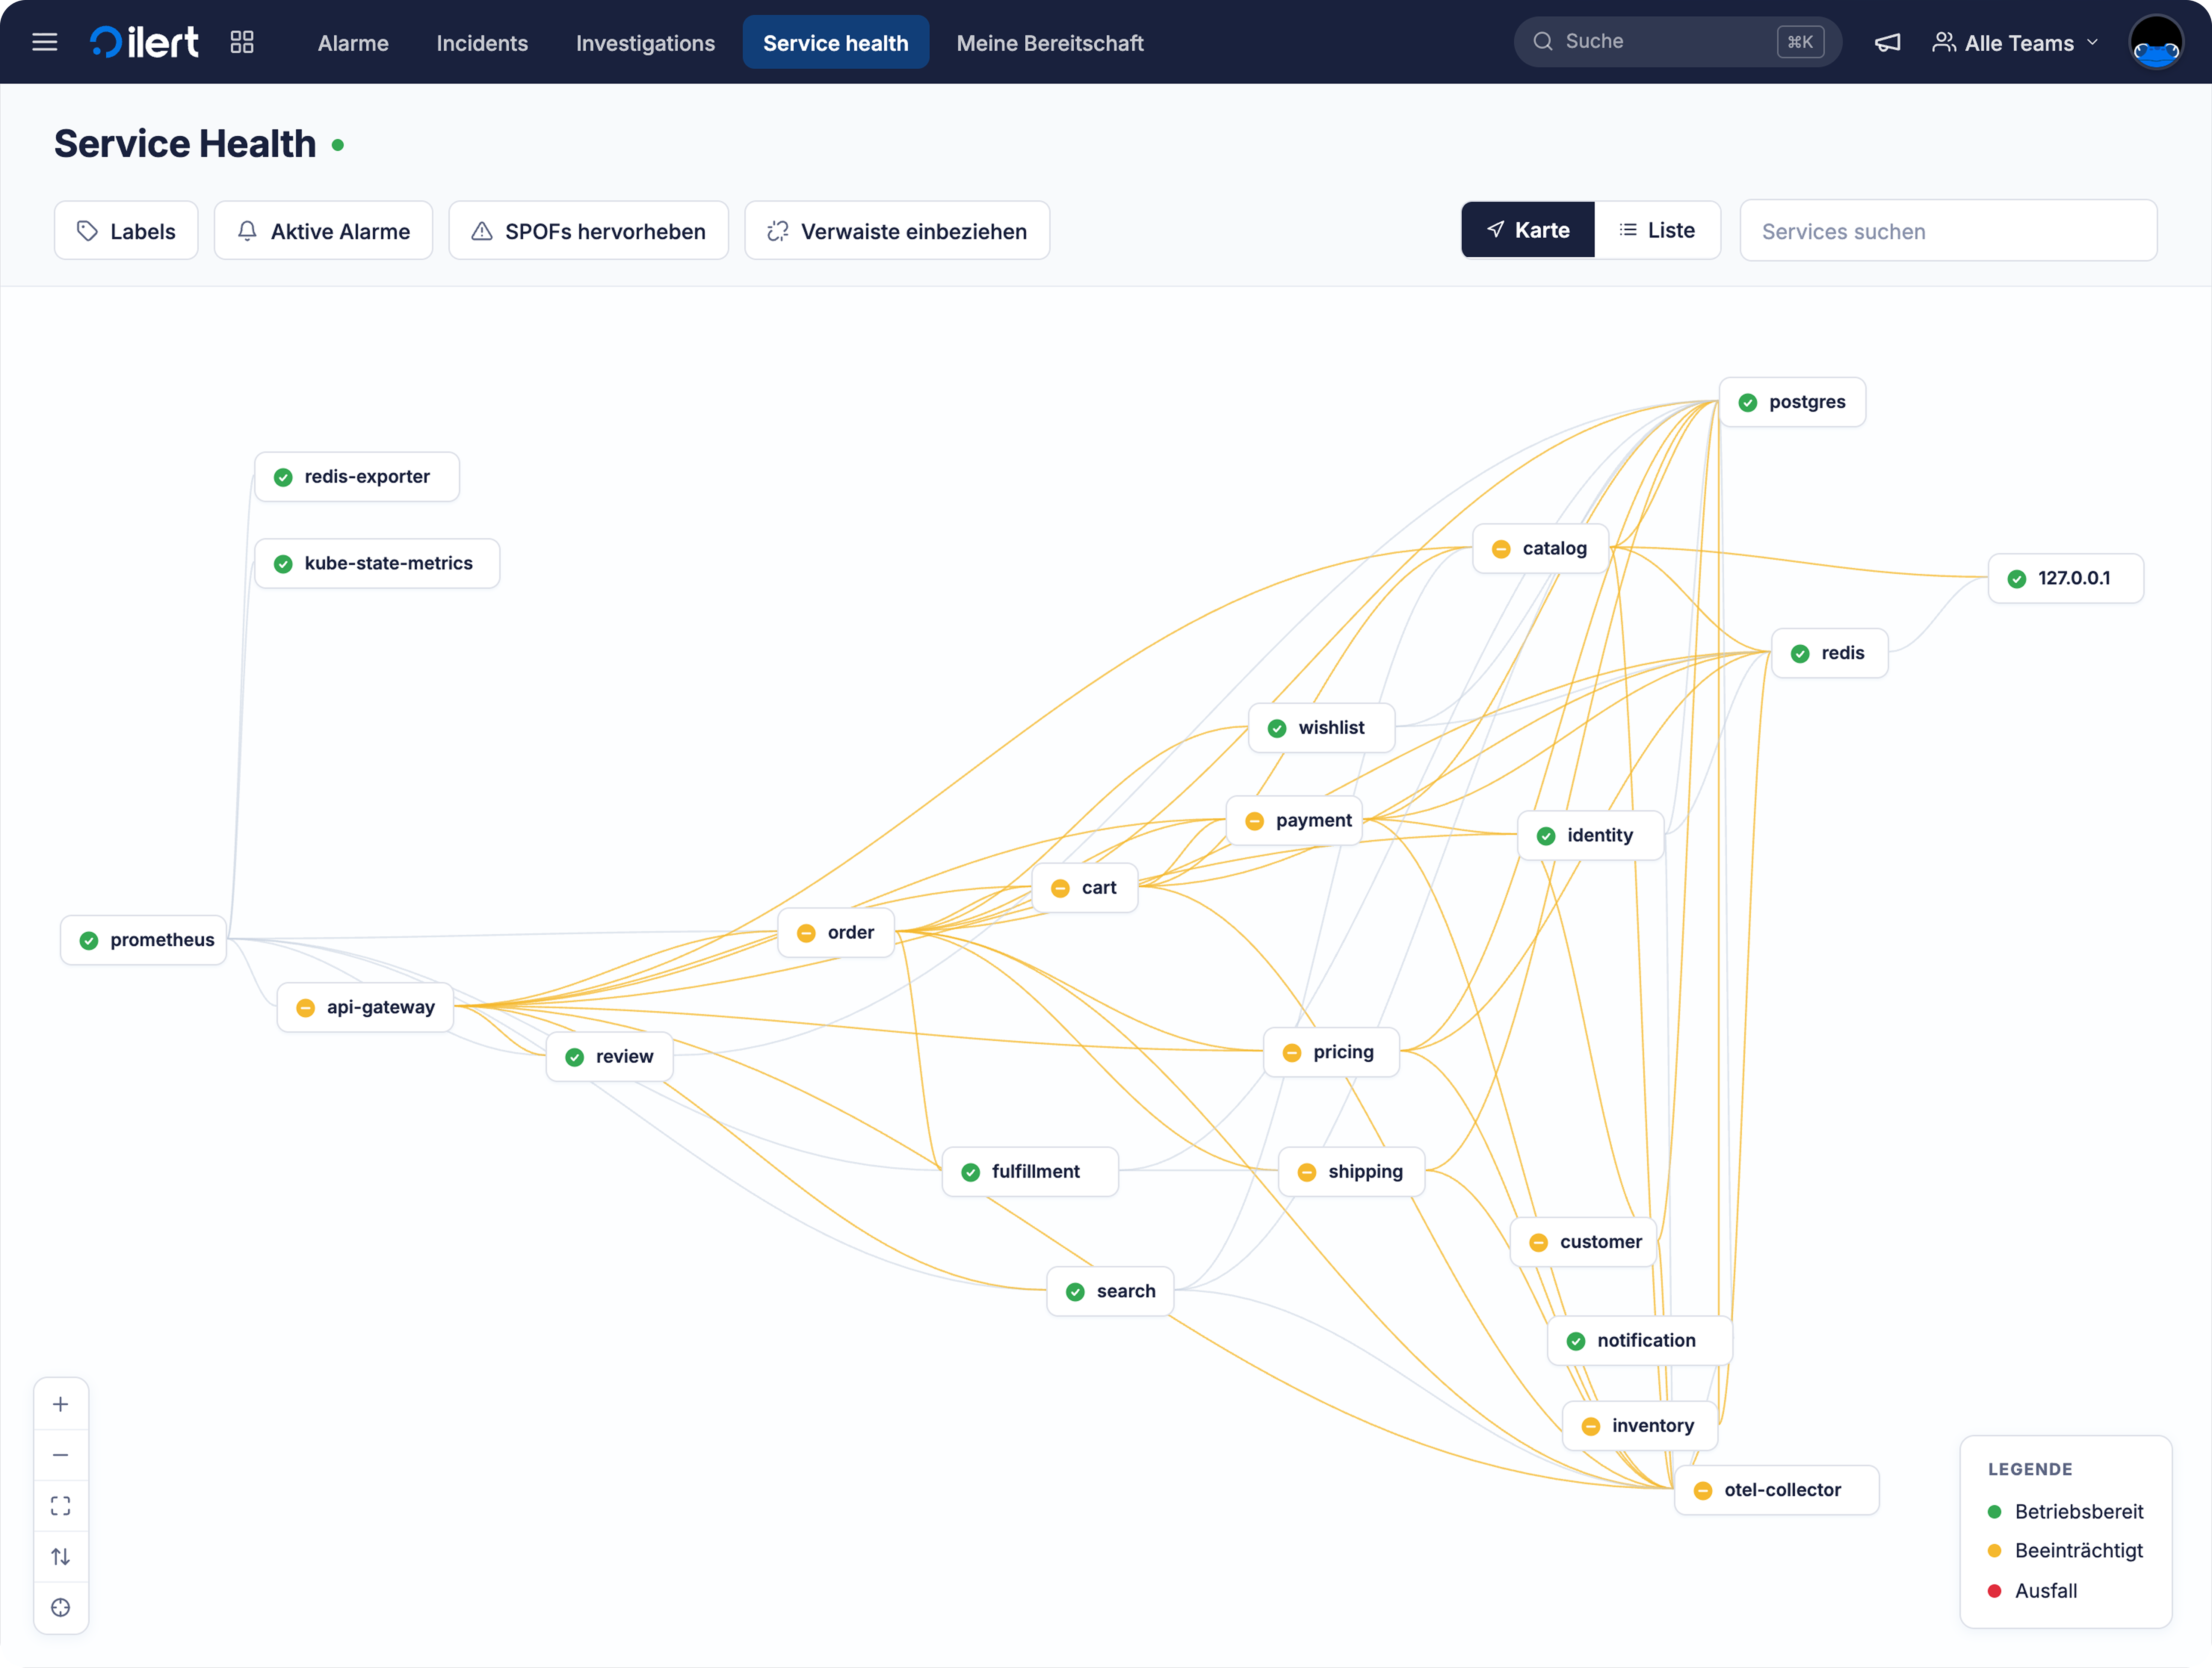
Mit der Zeit baut der Agent ein schlankes Langzeitgedächtnis für das implizite Wissen auf, das er sich aneignet – etwa Dinge wie: „Dieser Service stößt um Mitternacht immer an seine Grenzen, weil dann die Batch-Jobs laufen.“ Dieses Wissen wird als einfacher Text gespeichert. Es gibt keine Vektordatenbank, die synchron gehalten werden muss.
So testen wir den Agent
Für Root-Cause-Analysen gibt es keine feste Vorgehensweise – und genau das macht sie schwer zu testen. Deshalb setzen wir auf drei Ansätze.
Erstens: ein öffentlicher Benchmark. OpenRCA von Microsoft Research ist der anspruchsvollste öffentlich verfügbare Test für Root-Cause-Analysen, den ich kenne: 335 reale Fehlerfälle aus drei Produktivsystemen, 68 GB Telemetriedaten und eine Alles-oder-nichts-Bewertung pro Aufgabe. Was für einen vollen Punkt erforderlich ist, hängt von der jeweiligen Aufgabe ab: Bei manchen müssen die richtige Komponente, die Ursache und der Zeitpunkt identifiziert werden, andere werden anhand einer kleineren Teilmenge bewertet – teilweise reicht bereits die richtige Komponente.
Zum Zeitpunkt der Veröffentlichung des Papers löste die beste veröffentlichte Baseline – ein Agent auf Basis von Claude 3.5 Sonnet – rund 11 % der Fälle. Als wir unseren eigenen Benchmark durchführten, hatte sich der Stand auf dem Leaderboard bereits weiterentwickelt: Opus 4.6 lag bei ungefähr 36 %. Die 11 % sollten daher als Wert aus dem ursprünglichen Paper verstanden werden und nicht als heutiger Stand der Technik.
Bei einer Stichprobe von 50 Aufgaben aus allen drei Systemen löste unser erster Prototyp nach den strengen Bewertungskriterien 26 % der Fälle. Legt man die weiter gefasste Bewertung zugrunde, stimmte das Ergebnis in 30 % der Fälle mit der Ground Truth überein. Eine Analyse dauerte dabei im Schnitt rund neun Minuten.
Ich würde die 26 % eher als Untergrenze betrachten – und angesichts der kleinen Stichprobe entsprechend vorsichtig interpretieren. Wichtiger als die eigentliche Zahl sind jedoch zwei Erkenntnisse aus dem Test: Als wir dem Agenten direkten Zugriff auf die Rohdaten der Telemetrie über eine einfache Shell gaben, statt ihn mit unseren acht produktionsnahen Grafana- und Prometheus-Tools arbeiten zu lassen, stieg die Erfolgsquote nach den strengen Kriterien von 14 % auf 26 % – und das bei weniger Tool-Aufrufen. Mit anderen Worten: Wie die Tools gestaltet sind, ist alles andere als nebensächlich.
Hinzu kommt: OpenRCA arbeitet ausschließlich mit Telemetriedaten. Informationen zu Deployments, Konfigurationsänderungen oder Alarmierungen stehen dem Agenten dort nicht zur Verfügung. Im Produktiveinsatz gehören gerade Änderungen jedoch zu seinen wichtigsten Hinweisen auf die Ursache eines Incidents. Der Benchmark testet den Agenten also gewissermaßen mit angezogener Handbremse.
Im selben Durchlauf erreichte Claude Code mit unserem Investigator Prompt 38 % und schnitt damit besser ab als unser eigener Harness. Auch dieses Ergebnis veröffentlichen wir bewusst, denn genau daran messen wir uns intern: Wenn ein allgemeiner Coding Agent mit Ihrem Prompt besser abschneidet als der eigens dafür entwickelte Harness, dann muss der Harness noch besser werden.
Zweitens: Chaos-Tests. Wir erzeugen gezielt echte Fehler in einer realen Umgebung und geben dem Agenten nur das, was auch ein Engineer im Bereitschaftsdienst sehen würde: die Symptome. Der Agent erfährt nie, was wir absichtlich kaputtgemacht haben.
In rund einem Dutzend Szenarien – darunter fehlerhafte Deployments, fehlerhafte Konfigurationsänderungen, Ressourcenengpässe und Ausfälle von Abhängigkeiten – zeigte sich:
- In allen Testläufen wurde die richtige Root Cause identifiziert.
- Die mittlere Zeit von der Alarmierung bis zur ersten Erkenntnis lag bei 194 Sekunden.
- In 90 % der Testläufe entsprach die vorgeschlagene Behebungsmaßnahme dem Vorgehen unserer Engineers.
- Falsche Hypothese mit hoher Konfidenz: null. Genau diesen Wert beobachten wir am genauesten.
Drittens: Replay-Tests. Jede Analyse aus dem Produktivbetrieb wird aufgezeichnet: jeder Tool-Aufruf, jede Antwort und die abschließende Root-Cause-Analyse. Wenn wir ein Modell oder einen Prompt ändern, spielen wir diese Aufzeichnungen erneut durch und vergleichen die Ergebnisse – sowohl mithilfe eines LLM als Bewertungsinstanz als auch anhand der Ähnlichkeit der Embeddings. So erkennen wir Regressionen, wenn ein neues Modell veröffentlicht wird. Allerdings erfasst dieses Verfahren nicht alles: Eine Aufzeichnung deckt nur die Tools ab, die im ursprünglichen Durchlauf tatsächlich verwendet wurden.
Manchmal liegt der Agent falsch. Nicht im Sinne von Halluzinationen – davon sehen wir in einer stark kontextualisierten Umgebung nur sehr wenig. Sondern schlicht falsch: Er zieht aus den Symptomen mit hoher Sicherheit die falsche Schlussfolgerung über die Ursache. Die Konfidenzbewertung und die Links zu den Belegen sollen Ihnen ermöglichen, das innerhalb von weniger als einer Minute zu erkennen. Dann können Sie den Agenten entweder mit einer Rückfrage in die richtige Richtung lenken oder die Analyse selbst übernehmen.
Was der Agent nicht kann
Der Agent handelt nicht eigenständig. Jede Maßnahme muss freigegeben werden.
Er sieht nur die Systeme und Datenquellen, die Sie anbinden. Der größte Nutzen eines Agenten entsteht durch den Kontext, den er erhält. Wenn er nicht erkennen kann, dass gerade ein Deployment stattgefunden hat, kann er das Deployment auch nicht als Ursache identifizieren.
Fehlende Observability kann er nicht ausgleichen. Manche hoffen, dass sich dieser Schritt mit einem Agenten überspringen lässt. Das funktioniert nicht – zumindest noch nicht.
Auch darin, einen einmal eingeschlagenen falschen Weg selbstständig wieder zu verlassen, ist der Agent noch nicht besonders gut. Wenn der Suchraum groß und der Ausgangspunkt unklar ist, kann er sich festfahren. Dann hilft eine Rückfrage – oder Sie übernehmen die Analyse selbst.
Das ändert sich für Ihr Team
Die Gespräche, die wir heute mit Engineering-Verantwortlichen führen, unterscheiden sich deutlich von den früheren Diskussionen rund um MTTR. Ein Muster begegnet mir dabei immer wieder: Ein kleines, starkes SRE-Team übernimmt den First-Level-Bereitschaftsdienst für viele Produktteams, während der Agent die Triage und die erste Analyse übernimmt.
Faire Bereitschaftsrotationen führen normalerweise dazu, dass jedes Service-Team etwa fünf Personen vorhalten muss, nur um den Bereitschaftsdienst abzudecken. Wird der First-Level-Bereitschaftsdienst bei einem zentralen, durch KI unterstützten Team gebündelt, entfällt diese Vorgabe für die einzelnen Teams. Engineers verbringen mehr Zeit mit der Entwicklung und weniger Zeit in Incident-Konferenzen mit 25 Beteiligten. Gleiche Teamgröße, mehr betreute Services, geringere Kosten pro Incident.
Genau diese Form von „KI im IT-Betrieb“ halte ich für sinnvoll: nicht weniger Engineers, sondern Engineers, die dafür eingestellt wurden, Dinge zu entwickeln, und genau das auch tun können. Niemand wurde eingestellt, um Vollzeit Bereitschaftsdienst zu leisten.
Ihre Daten
Alle KI-Workloads laufen auf dedizierter Infrastruktur in unseren EU-Regionen Frankfurt und Stockholm. Die Modelle werden über regionale Endpoints aufgerufen. Wir trainieren nicht mit Ihren Daten und haben bei allen von uns eingesetzten Modellanbietern der Nutzung zu Trainingszwecken widersprochen.
Für Analysen benötigt der Agent ausschließlich API-Keys mit Lesezugriff. Personenbezogene Daten und Daten auf Nutzerebene werden nicht an externe Modelle weitergegeben. Wenn Ihr Security-Team eigene Modell-API-Keys hinter den unternehmenseigenen Guardrails verwenden möchte, unterstützen wir auch dieses Modell.
Weitere Informationen: https://docs.ilert.com/trust-center
Verfügbarkeit
Der AI SRE ist ab heute in allen kostenpflichtigen Tarifen sowie während der Testphase verfügbar und nutzt die in Ihrem Tarif enthaltenen AI Credits: 250 pro Monat im Pro-Tarif, 1.000 im Scale-Tarif und 5.000 im Enterprise-Tarif. Sie können Ihr enthaltenes Kontingent einsehen und selbst festlegen, was passieren soll, wenn es aufgebraucht ist.
Für bestehende Kunden ist keine Migration erforderlich. Aktivieren Sie den AI SRE unter Account settings → AI features, erstellen Sie einen Agenten, verbinden Sie ihn mit Ihren Tools und starten Sie beim nächsten Incident Ihre erste Analyse.
Wo geht die Reise hin?
Unser Ziel ist, dass Sie um 3 Uhr nachts gar nicht mehr alarmiert werden. Stattdessen wachen Sie morgens auf und finden einen Bericht vor: Der Agent hat die akuten Auswirkungen eingedämmt, eine Stunde lang überprüft, dass die Symptome nicht wieder aufgetreten sind, und für die eigentliche Behebung liegt bereits ein Pull Request bereit.
So weit sind wir zum Start der allgemeinen Verfügbarkeit noch nicht. Der aktuelle Stand ist: Die Fehlersuche dauert nur noch wenige Minuten statt einer Stunde, lässt sich mit einem Klick starten und die vorgeschlagene Behebung ist nur einen weiteren Klick entfernt.
Das Vertrauen für alles, was darüber hinausgeht, muss sich der Agent Schritt für Schritt mit jeder einzelnen Analyse verdienen. Und genau hier beginnt diese Reise.
Wenn Sie ein Szenario kennen, bei dem Sie vermuten, dass der Agent falsch liegen wird, würde ich sehr gerne davon hören.